Exponential concentration in quantum kernel methods
Concentration exponentielle dans les méthodes à noyau quantiques
Mots-clés
Résumé
272 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de l’exposé réside dans la clarification d’un point contre-intuitif : les méthodes à noyaux quantiques sont souvent présentées comme exemptes des pathologies d’optimisation des circuits variationnels, parce que l’entraînement est convexe et que le calculateur quantique ne sert qu’à estimer la matrice de Gram. L’auteur montre que cette garantie de convexité ne protège en rien contre la concentration exponentielle, qui se déplace simplement de l’espace des paramètres vers l’espace des données d’entrée. L’argumentation est structurée et progressive : définition formelle du modèle, rappel du barren plateau, analogie par vectorisation de la fonction de perte, puis transposition au cadre des noyaux. Le raisonnement central — la fonction de perte comme produit scalaire d’objets de dimension exponentielle, dont le recouvrement aléatoire décroît comme l’inverse de la dimension — est exposé de manière intuitive et convaincante. L’auteur distingue soigneusement les sources de concentration et les conséquences, et souligne que la conséquence pratique (modèle insensible aux données) découle de l’estimation bruitée du noyau, non de la concentration seule. L’argument sur l’indiscernabilité statistique entre distribution du noyau et distribution uniforme est particulièrement éclairant : il explique pourquoi l’entraînement peut sembler fonctionner tout en produisant un modèle trivial. La démonstration par l’exemple de régression ridge, où le modèle mémorise sans généraliser et où l’ajout de données n’aide pas, renforce l’argument. On peut regretter l’absence de détails quantitatifs sur les bornes de concentration et sur les régimes exacts où elles s’appliquent, ainsi que le caractère oral et non démontré de certaines affirmations.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est élevée : les résultats présentés sont adossés à une publication évaluée par les pairs dans Nature Communications, dont le lien figure dans la description. L’auteur est le chercheur principal des travaux et présente des résultats analytiques (bornes de concentration dérivées pour chaque source) complétés par des simulations numériques sur plusieurs tâches de QML. Le vocabulaire technique est employé avec précision (test d’overlap, swap test, matrice de Gram, régression ridge, test d’hypothèse), et l’auteur signale explicitement une coquille dans une formule affichée, ce qui témoigne d’une certaine transparence. Les sources citées sont limitées à la publication principale et à une revue mentionnée oralement sans référence précise. L’adéquation titre/contenu est bonne : le titre annonce la concentration exponentielle dans les méthodes à noyaux quantiques, qui constitue bien le cœur de la seconde partie, la première partie servant de cadre introductif sur les barren plateaus. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
421 mots
Adéquation titre / contenu
Le titre correspond exactement au contenu : la seconde moitié de l'exposé est consacrée à la concentration exponentielle des valeurs de noyaux quantiques, ses sources et ses conséquences. La première partie, plus introductive, traite du barren plateau dans les algorithmes quantiques variationnels, ce qui élargit légèrement le périmètre annoncé.
Qualité & fiabilité
8/10
Exposé de recherche adossé à une publication évaluée par les pairs dans Nature Communications, présenté par l'auteur principal des travaux. Les résultats sont explicités analytiquement (bornes de concentration dérivées pour quatre sources : expressivité de l'encodage, mesures globales, intrication, bruit) et validés par simulations numériques. Le format séminaire reste toutefois une présentation orale non révisée, sans démonstrations détaillées à l'écran, ce qui limite la vérifiabilité immédiate pour l'auditeur.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Définition d'un modèle de machine learning comme fonction paramétrée et introduction du QML.
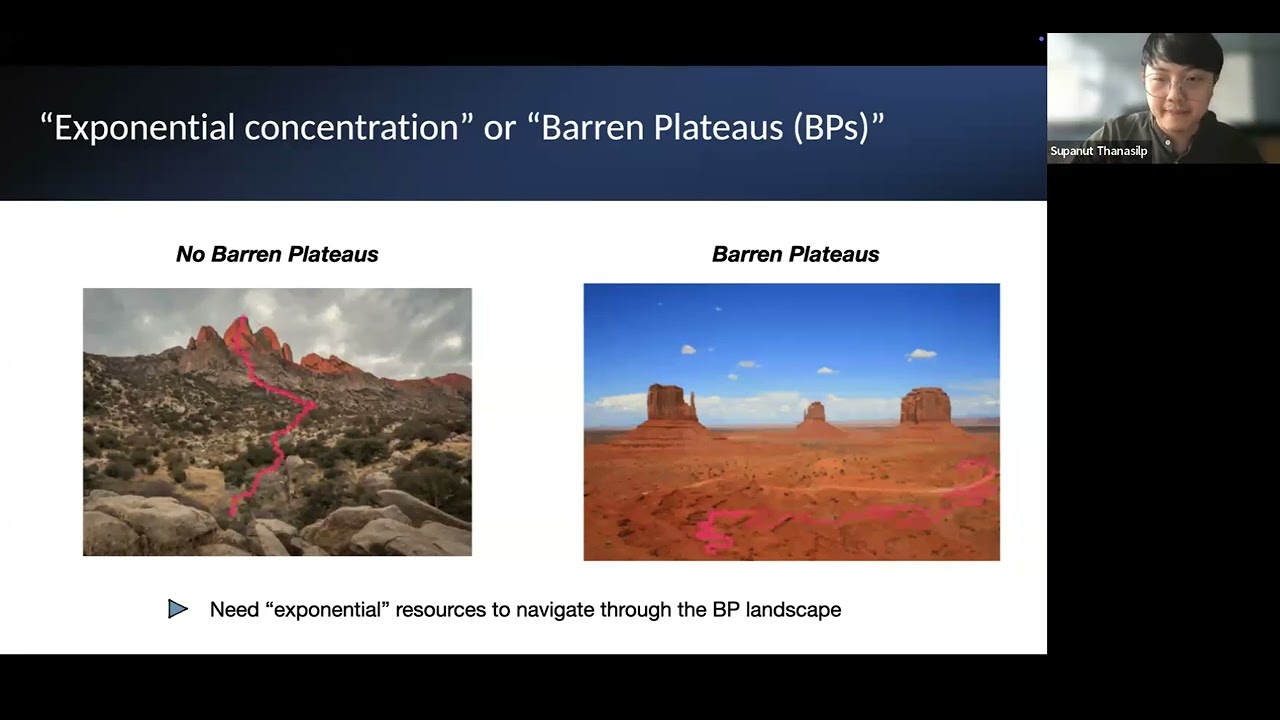
- Présentation du problème du barren plateau et de la variance décroissant exponentiellement avec le nombre de qubits.
- Explication du barren plateau par la malédiction de la dimensionnalité et le produit scalaire d'objets de dimension exponentielle.
- Transition vers les méthodes à noyaux quantiques et définition du noyau comme mesure de similarité entre états encodés.
- Avantage de convexité de l'entraînement par noyau et rôle du calculateur quantique limité à l'estimation de la matrice de Gram.
- Transposition de la concentration exponentielle de l'espace des paramètres vers l'espace des données d'entrée.
- Identification des quatre sources de concentration : expressivité, mesures globales, intrication et bruit.
- Conséquence : modèle entraîné insensible aux données du fait de l'estimation bruitée du noyau.
- Test d'hypothèse montrant l'indiscernabilité statistique entre distribution du noyau et distribution uniforme.
- Exemple de régression ridge : mémorisation parfaite sans généralisation, insensible à l'ajout de données d'entraînement.
Sources citées
- Exponential concentration in quantum kernel methods (Nature Communications) — Publication principale de l'exposé, référencée dans la description de la vidéo ; elle contient les bornes analytiques de concentration et les simulations numériques présentées.
Sources concordantes
- Exponential concentration in quantum kernel methods (Nature Communications) — Publication de référence de l'exposé, cohérente avec l'ensemble des résultats présentés oralement.
Apport & nouveautés
L’apport original réside dans le transfert systématique de l’analyse du barren plateau, développée pour les algorithmes quantiques variationnels, vers les méthodes à noyaux quantiques. Là où ces dernières étaient souvent considérées comme protégées par la convexité de leur entraînement, l’auteur montre que la concentration exponentielle se manifeste dans l’espace des données d’entrée plutôt que dans celui des paramètres. Le travail identifie quatre sources distinctes de concentration — expressivité de l’encodage, mesures globales, intrication et bruit — et dérive pour chacune une borne analytique. Il établit surtout une conséquence pratique nouvelle : en présence de concentration et de bruit de mesure, le modèle entraîné devient insensible aux données, ses valeurs de noyau estimées étant statistiquement indiscernables de celles d’une distribution fixe. Cette analyse est formalisée par un test d’hypothèse et illustrée par une régression ridge où l’ajout de données d’entraînement n’améliore pas la généralisation. L’extension aux modèles sans paramètres quantiques, comme l’extreme learning et le quantum reservoir computing, élargit la portée du résultat.
Pour aller plus loin :
- Barren plateaus — Concept central de la première partie, décrivant l’aplatissement exponentiel du paysage d’optimisation des circuits variationnels.
- Quantum machine learning — Cadre général dans lequel s’inscrivent les méthodes à noyaux quantiques discutées.
- Méthode à noyaux — Fondement classique des méthodes à noyaux, dont le noyau quantique est la transposition.
- Matrice de Gram — Objet dont l’estimation par le calculateur quantique conditionne l’entraînement du modèle.
- Test d’hypothèse statistique — Outil formel employé pour montrer l’indiscernabilité des valeurs de noyau estimées.
247 mots
Profil radar
Le profil est celui d'un exposé de recherche théorique de haut niveau : quantité et qualité d'information élevées, niveau technique très élevé, avec une fiabilité soutenue par une publication évaluée par les pairs. Le léger déficit de quantité d'information reflète le format oral, qui laisse plusieurs démonstrations et bornes à l'état d'évocation.