Exponential quantum advantages in learning quantum observables from classical data
Avantages quantiques exponentiels dans l'apprentissage d'observables quantiques à partir de données classiques
Mots-clés
Résumé
179 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
L’exposé présente une contribution théorique originale et bien structurée. La valeur informative est élevée : l’orateur clarifie la distinction entre calculer et apprendre une fonction, illustre par des exemples concrets (classification d’images, fonction trigonométrique issue de la formule de paramètre de porte), et expose les deux voies classiques de séparation (fonctions cryptographiques avec données générables classiquement, et problèmes BQP-complets sous hypothèse de complexité). L’argumentation progresse logiquement : motivation, cadre formel, résultats antérieurs, limites, puis contribution. Les théorèmes sont énoncés avec leurs hypothèses, et la preuve est décomposée en deux parties (dureté classique, apprenabilité quantique). La démonstration de dureté classique repose sur l’encodage d’un problème BQP-complet dans l’évolution temporelle d’un hamiltonien local, ce qui est un argument solide mais conditionnel. L’apprenabilité quantique est établie via un algorithme non trivial utilisant la préparation d’états et une régression Lasso, ce qui renforce la crédibilité. Les limites sont honnêtement mentionnées : hypothèses non prouvées, absence de garantie inconditionnelle. L’orateur ne surinterprète pas ses résultats et situe clairement son travail par rapport à la littérature existante.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est élevée : les définitions sont précises, les hypothèses de complexité sont explicitées, et les résultats sont présentés comme conditionnels. La source principale est l’article arXiv (2405.02027), mentionné dans la description et accessible. Le transcript ne cite pas d’autres travaux spécifiques, mais l’orateur fait référence à des résultats antérieurs (Casper et al., « Power of data ») sans les nommer explicitement. L’adéquation titre/contenu est excellente : le titre reflète exactement le sujet traité. Aucun chapitre n’est défini par le créateur, ce qui rend les moments clés d’autant plus utiles pour la navigation.
281 mots
Adéquation titre / contenu
Le titre correspond exactement au contenu : l'orateur présente des séparations d'apprentissage quantique exponentiel pour des observables quantiques à partir de données classiques. Aucun écart notable.
Qualité & fiabilité
9/10
Exposé de recherche original, présenté par l'auteur principal, avec énoncés de théorèmes, hypothèses de complexité explicites et référence arXiv. Les résultats sont conditionnels à des hypothèses non prouvées (BQP ⊄ P/poly, etc.), ce qui est clairement signalé. Aucune source externe n'est citée dans le transcript, mais le lien arXiv permet de vérifier le contenu.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction par l'hôte et présentation de l'orateur.
- Question centrale : quand les ordinateurs quantiques sont-ils avantageux pour l'apprentissage ?
- Rappel des avantages quantiques connus : cryptographie et simulation quantique.
- Présentation du cadre PAC pour l'apprentissage supervisé.
- Différences entre calculer et apprendre une fonction : écart de données, apprenabilité quantique, complexité en moyenne.
- Exemple de la fonction trigonométrique et de l'impact des données sur la dureté.
- Séparations existantes : fonctions cryptographiques et problèmes BQP-complets.
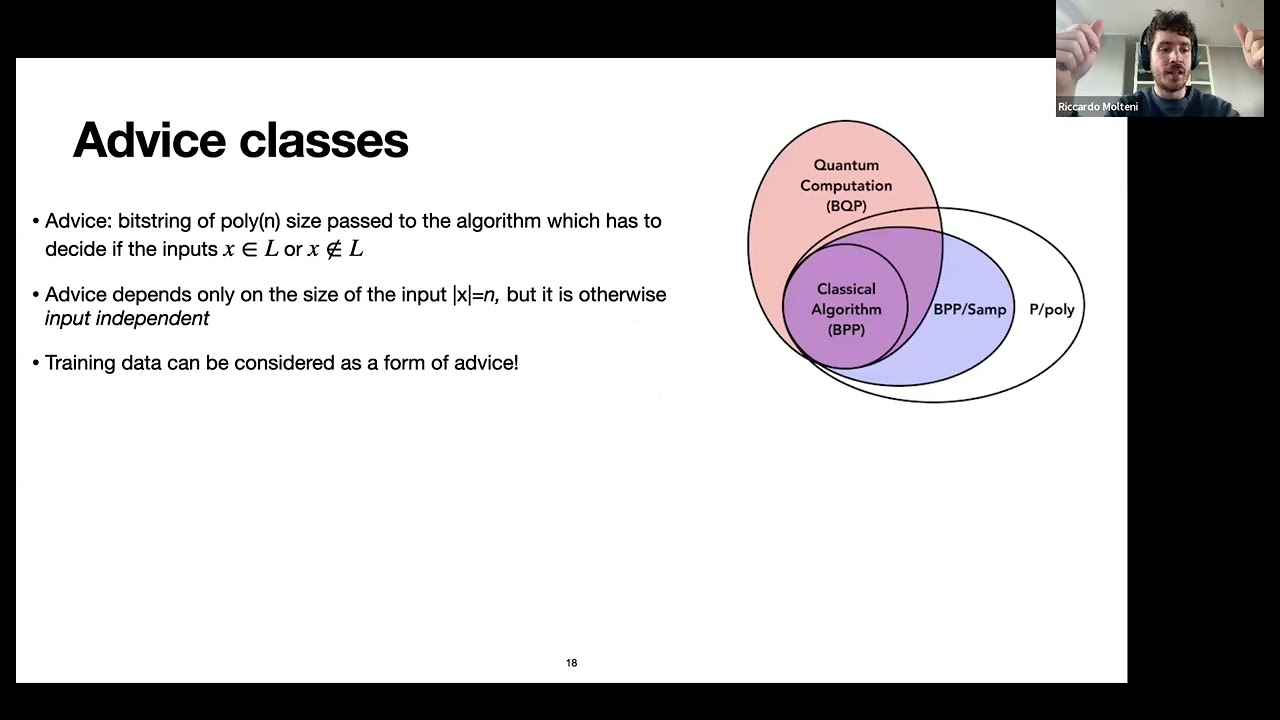
- Introduction des classes avec conseil (advice) et de herP/poly.
- Énoncé du théorème principal : avantage quantique pour l'apprentissage d'observables.
- Preuve de dureté classique par encodage d'un problème BQP-complet.
- Algorithme quantique d'apprentissage : préparation d'états et régression Lasso.
Sources citées
- Exponential quantum advantages in learning quantum observables from classical data — Article original présenté par l'orateur, disponible sur arXiv.
Apport & nouveautés
Cet exposé présente une contribution originale : il établit des séparations d’apprentissage quantique exponentiel pour des tâches physiquement pertinentes, contrairement aux travaux antérieurs qui reposaient sur des fonctions cryptographiques ou des problèmes abstraits. L’apport réside dans la construction explicite d’un hamiltonien local et d’observables tels que l’apprentissage d’observables quantiques à partir de données classiques est classiquement difficile mais quantiquement efficace. L’algorithme quantique proposé n’est pas une simple recherche de Grover mais utilise la préparation d’états évolués et une régression Lasso, ce qui le rend non trivial. L’extension aux états fondamentaux élargit la portée des résultats.
Pour aller plus loin :
- Apprentissage PAC — Cadre théorique fondamental pour l’apprentissage supervisé, utilisé dans l’exposé.
- BQP — Classe de complexité quantique, centrale dans les hypothèses de séparation.
- Lasso — Méthode de régression utilisée dans l’algorithme quantique d’apprentissage.
- Hamiltonien (mécanique quantique) — Concept clé pour la simulation quantique et les observables.
147 mots
Profil radar
Le profil radar montre une très forte quantité d'information et un niveau technique maximal, avec une qualité et une fiabilité élevées. La note globale reflète un exposé spécialisé, rigoureux et bien argumenté, destiné à un public expert.