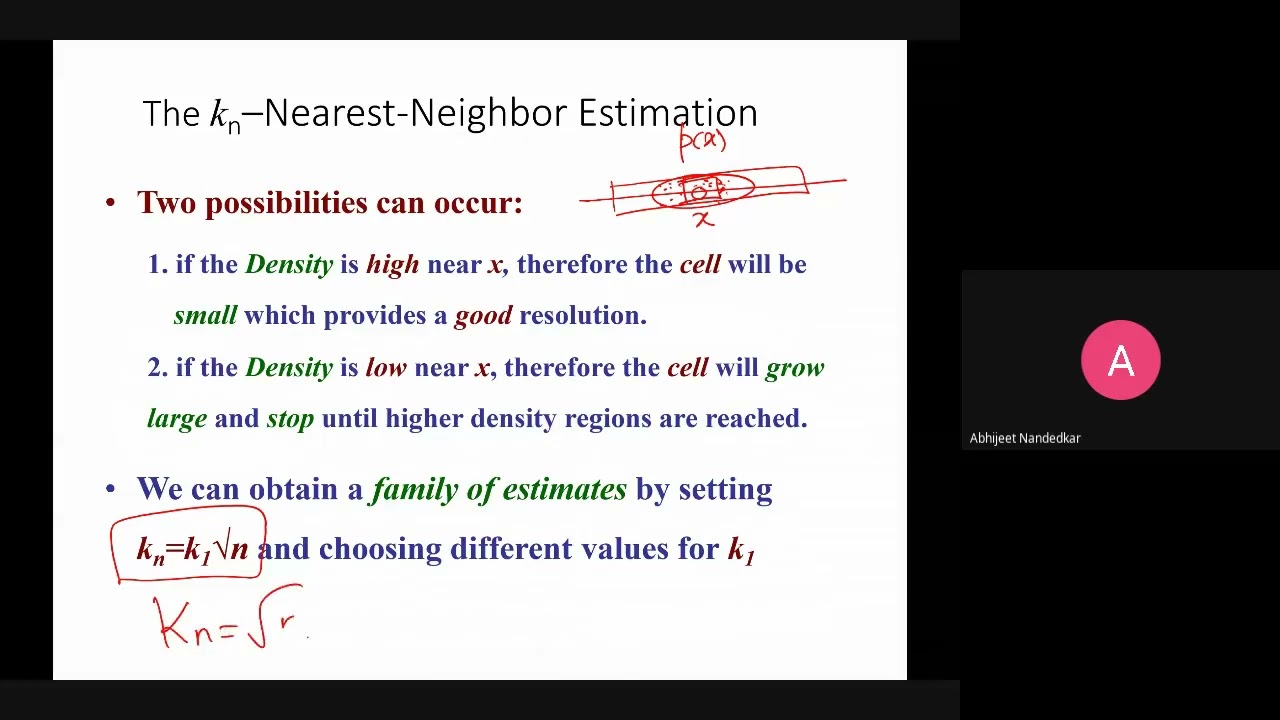
23 ml KNN estimate
Estimation KNN de 23 ml
Mots-clés
Résumé
321 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur informative de cette vidéo réside dans la clarté de la progression pédagogique : l’enseignant construit son propos en contrastant systématiquement la fenêtre de Parzen (volume fixe, nombre d’échantillons variable) et l’estimation KNN (nombre de voisins fixe, volume variable), ce qui permet de saisir l’inversion conceptuelle entre les deux approches. La formule centrale p(x) = k/(nV) est réutilisée de manière cohérente dans tous les exemples, ce qui renforce la compréhension. L’argumentation repose sur des exemples numériques entièrement déroulés à la main : comptage des échantillons dans une fenêtre, élargissement progressif de h (de 0,5 à 1,0 dans le premier exemple, de 0,2 à 1,0 dans le second), calcul des vraisemblances conditionnelles, puis application de la règle de Bayes. Cette démarche pas à pas constitue la principale force argumentative : chaque étape est justifiée par le résultat de la précédente. L’enseignant prend soin de distinguer explicitement deux notions souvent confondues — l’estimation KNN (qui produit une densité) et la règle KNN (qui produit directement une décision de classe) — et insiste sur le fait que la seconde est plus populaire car elle court-circuite l’estimation des vraisemblances. La démonstration du lien entre vote majoritaire et probabilité a posteriori (p(Ωi|x) = ki/k) est menée rigoureusement, en passant par la probabilité jointe et la formule de Bayes. En revanche, l’argumentation reste purement théorique et unidimensionnelle : aucune expérience sur données réelles, aucune comparaison empirique avec d’autres classifieurs, aucune discussion des choix de k ou des métriques de distance. La limite de non-normalisation de la densité est signalée mais non approfondie.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique du contenu est solide pour un cours introductif : les formules sont correctes, les notations cohérentes (n, k, V, Ωi, p(x|Ωi), p(Ωi|x)), et la distinction entre estimation et règle KNN est maintenue sans ambiguïté. L’enseignant signale spontanément une faiblesse mathématique de la méthode (intégrale de la densité non finie lorsque n = 1), ce qui est un gage de sérieux. Toutefois, aucune source bibliographique n’est citée : ni Duda & Hart (Pattern Classification), ni Bishop (Pattern Recognition and Machine Learning), ni les articles fondateurs de Fix & Hodges ou Cover & Hart sur la règle KNN. Aucun lien, aucune référence en description. La vidéo s’appuie donc uniquement sur l’autorité de l’enseignant, ce qui limite sa traçabilité scientifique. Concernant l’adéquation titre/contenu, le titre « 23 ml KNN estimate » est très bref et correspond bien au sujet traité (estimation KNN), mais il est peu informatif et ne mentionne ni la fenêtre de Parzen ni la règle KNN, pourtant largement abordées. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
446 mots
Qualité & fiabilité
7/10
Cours magistral de niveau universitaire portant sur l'estimation non paramétrique de densité (fenêtre de Parzen, estimation k-plus-proches-voisins, règle k-NN). Le contenu est mathématiquement cohérent : formule p(x)=k/(nV), distinction entre fenêtre fixe et fenêtre croissante, démonstration du lien entre vote majoritaire et estimation de la probabilité a posteriori (ki/k). Les exemples numériques unidimensionnels sont déroulés pas à pas et vérifiables. Aucune source bibliographique n'est citée explicitement, mais le matériau correspond à un enseignement classique (Duda & Hart, Bishop). La vidéo signale elle-même une limite importante de la méthode (intégrale de la densité non finie quand n=1), ce qui témoigne d'une certaine honnêteté intellectuelle. La qualité audio/transcription est médiocre (répétitions, hésitations), ce qui nuit légèrement à la clarté mais pas à l'exactitude.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel de la fenêtre de Parzen (méthode à fenêtre rétrécissante) et introduction de l'estimation KNN comme méthode à fenêtre croissante.
- Distinction terminologique entre estimation KNN (knn estimation) et règle KNN (knn rule), avec mise en garde contre la confusion.
- Procédure de l'estimation KNN : centrage d'une cellule autour de x, choix de k = racine de n, élargissement progressif de la fenêtre jusqu'à capturer k échantillons.
- Formule de la densité p(x) = k/(nV) et discussion de l'effet du nombre de voisins sur le lissage de l'estimation.
- Limite de la méthode : cas n = 1, k = 1, densité qui ne tend jamais vers zéro et intégrale non finie.
- Exemple numérique détaillé : estimation de p(x) en x = 3,1 avec k = 6, élargissement de h de 0,5 à 1,0, résultat p = 0,3.
- Exemple de classification à deux classes : estimation des vraisemblances p(x|Ω1) et p(x|Ω2) par élargissement de fenêtre, puis application de la règle de Bayes.
- Introduction de la règle KNN : attribution directe de la classe majoritaire parmi les k plus proches voisins, sans estimation préalable de densité.
- Démonstration du lien entre vote majoritaire et probabilité a posteriori : p(Ωi|x) = ki/k, avec exemple à trois classes (3, 5 et 2 échantillons sur 10).
- Conclusion : la règle KNN est la plus simple à implémenter et la plus populaire car elle estime directement la probabilité a posteriori.
Apport & nouveautés
Cette vidéo n’apporte pas de résultat original : il s’agit d’un cours magistral qui restitue un contenu classique de reconnaissance de formes et d’apprentissage statistique. Son apport réside dans la clarté de l’exposition et dans la distinction pédagogique entre trois notions souvent confondues : la fenêtre de Parzen (volume fixe), l’estimation KNN (nombre de voisins fixe) et la règle KNN (décision directe par vote). La démonstration du lien entre vote majoritaire et probabilité a posteriori, bien que standard, est présentée de manière progressive et accessible. L’enseignant signale également une limite mathématique importante de l’estimation KNN (non-normalisation de la densité), ce qui constitue un point de vigilance utile pour l’étudiant. En revanche, la vidéo reste purement théorique et unidimensionnelle, sans application sur données réelles ni discussion des choix pratiques (valeur de k, métrique de distance, malédiction de la dimensionnalité).
Pour aller plus loin :
- k-nearest neighbors algorithm — Article encyclopédique couvrant la règle KNN, ses variantes et ses applications.
- Kernel density estimation — Présentation de l’estimation de densité par noyau, dont la fenêtre de Parzen est un cas particulier.
- Naive Bayes classifier — Contexte plus large de la classification bayésienne, dont la règle KNN est une approximation non paramétrique.
- Richard O. Duda, Peter E. Hart et David G. Stork, Pattern Classification — Ouvrage de référence traitant en détail la fenêtre de Parzen et la règle KNN.
- Christopher M. Bishop, Pattern Recognition and Machine Learning — Manuel couvrant l’estimation non paramétrique de densité et les méthodes de voisinage.
246 mots
Profil radar
Le profil radar est celui d'un cours théorique solide mais sans ambition empirique : quantité d'information et niveau technique élevés, qualité et fiabilité bonnes, mais absence totale de sources citées et d'expérimentation sur données réelles. Le contenu est fiable sur le plan mathématique mais limité à une exposition unidimensionnelle et sans mise en perspective bibliographique.