Lecture 30 Size of Network , Functional Link Networks 2021 11 22 at 01 32 GMT 8
Cours 30 Taille du réseau , Réseaux à liens fonctionnels 2021 11 22 à 01 32 GMT 8
Mots-clés
Résumé
250 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
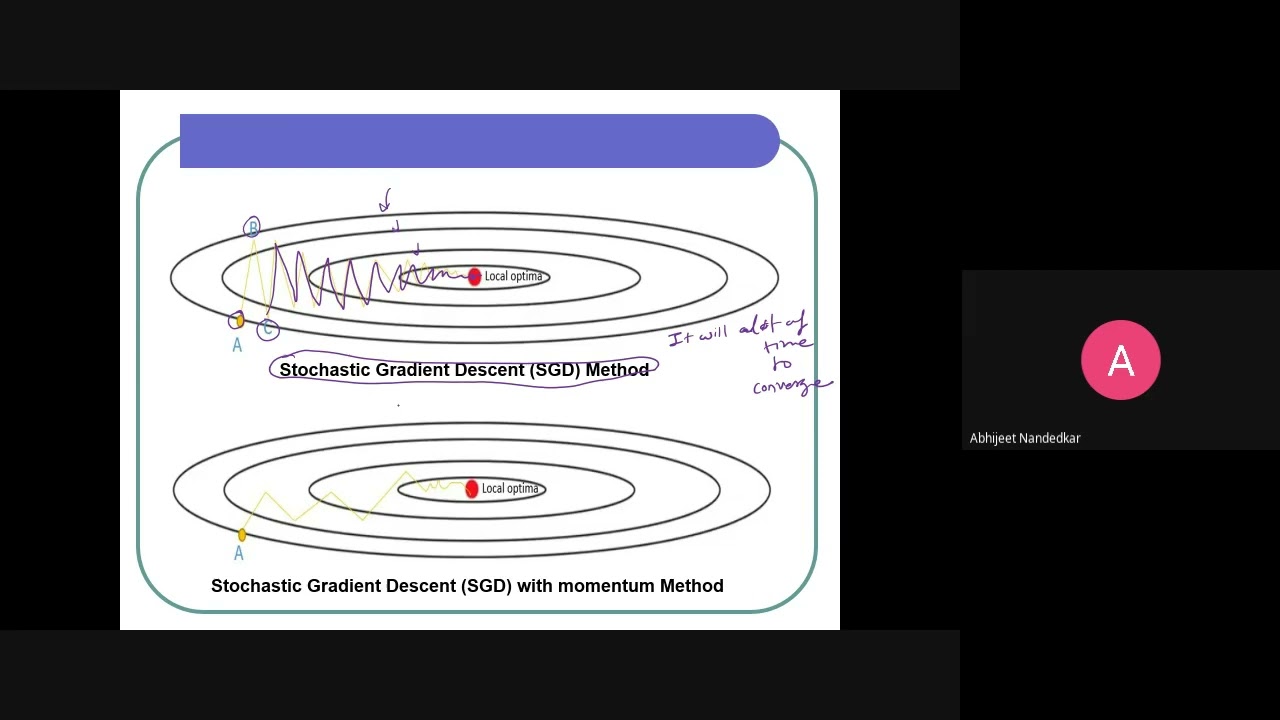
La valeur informative de cette séance réside dans sa progression pédagogique claire : du mécanisme local du momentum à la question globale du dimensionnement d’une architecture, puis à une variante architecturale précise. Le raisonnement sur le momentum est solide et correctement articulé : l’ajout d’une fraction du vecteur de gradient précédent au gradient courant est justifié par l’accélération de la convergence et par la réduction des oscillations sur des contours elliptiques, avec une illustration géométrique cohérente (construction du parallélogramme, comparaison des trajectoires A→B→C et A→B→C’). L’argumentation sur la taille du réseau est plus faible : elle repose sur des règles empiriques explicitement présentées comme telles (‘ce n’est pas fixe’), sans démonstration ni référence à des travaux sur la capacité ou la généralisation. L’affirmation selon laquelle deux à trois couches cachées suffisent à la plupart des problèmes est plausible mais non étayée. Le passage sur les CNN est descriptif et correct dans ses grandes lignes, mais l’explication de la hiérarchie des caractéristiques (du trait élémentaire à l’objet) reste qualitative. La démonstration du XOR par enrichissement de caractéristiques est en revanche la partie la plus rigoureuse : le passage d’un espace 2D non séparable à un espace 3D séparable par le plan X3 = X1·X2 est correctement construit et constitue une preuve valide que la non-linéarité peut être absorbée par une transformation des entrées. L’intervenant signale honnêtement la limite pratique de cette approche : l’absence de méthode générale pour choisir les caractéristiques dérivées pertinentes, ce qui explique le peu de succès industriel de ces réseaux. La mention des réseaux multicouches comme approximateurs universels est exacte mais énoncée sans conditions ni référence au théorème sous-jacent.
Rigueur scientifique, qualité des sources, adéquation du titre
Aucune source n’est citée dans la vidéo ni dans la description, qui est vide : pas de bibliographie, pas d’article de référence, pas d’URL. Les architectures évoquées (LeNet 1998, AlexNet 2012, VGG 2014, GoogLeNet 2015, Inception v3/v4, ResNet) sont nommées avec leurs années et parfois leurs nombres de paramètres, ce qui fournit des repères factuels utiles, mais sans renvoi aux publications originales. Deux imprécisions sont notables : VGG est attribué à ‘Andrew Jackson’ alors qu’il s’agit de Karen Simonyan et Andrew Zisserman, et la chronologie des versions d’Inception est approximative. Le chiffre de 0,06 million de paramètres pour LeNet et de 16 millions pour AlexNet est cohérent avec la littérature. Le titre correspond au contenu : la taille du réseau et les réseaux à liens fonctionnels occupent bien la majeure partie de la séance, le rappel sur le momentum servant d’introduction. Aucun commentaire n’étant fourni, aucune analyse des tendances du public n’est formulée.
440 mots
Adéquation titre / contenu
Le titre annonce bien le contenu : la seconde moitié de la séance traite effectivement de la taille des réseaux et des réseaux à liens fonctionnels, après un rappel sur le momentum.
Qualité & fiabilité
6/10
Cours magistral universitaire cohérent, sans source citée ni référence bibliographique explicite. Les notions présentées (momentum, SGD, dimensionnement des couches, VGG, LeNet, AlexNet, Inception, réseaux à liens fonctionnels, théorème d'approximation universelle) sont exactes et conformes à la littérature, mais aucune donnée chiffrée n'est sourcée et certaines attributions sont approximatives (VGG attribué à 'Andrew Jackson' au lieu d'Andrew Zisserman/Karen Simonyan). Aucune URL ni référence vérifiable n'est fournie dans la description, qui est vide.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Rappel du terme de momentum ajouté au gradient négatif de la rétropropagation.
- Illustration géométrique du momentum sur des contours d'erreur elliptiques et comparaison des trajectoires.
- Passage au dimensionnement du réseau : nombre de nœuds d'entrée égal au nombre de caractéristiques.
- Nombre de nœuds de sortie égal au nombre de réponses désirées (classes ou fonctions).
- Choix du nombre de couches cachées selon la complexité et la non-linéarité du problème.
- Présentation de VGG-16/19 et du rôle des dernières couches entièrement connectées.
- Hiérarchie des caractéristiques extraites par les couches convolutives, illustrée par le dessin d'un œil.
- Historique des CNN : LeNet, AlexNet, VGG, GoogLeNet, Inception et évolution du nombre de paramètres.
- Introduction des réseaux à liens fonctionnels et de la contrainte de couche unique.
- Résolution du XOR par ajout de la caractéristique dérivée X3 = X1·X2 et séparation linéaire en 3D.
- Limite pratique des réseaux à liens fonctionnels : choix des caractéristiques dérivées.
- Réseaux de régression présentés comme approximateurs universels.
Apport & nouveautés
Cette séance n’apporte pas de résultat original : il s’agit d’un cours qui synthétise des notions classiques. Son intérêt réside dans l’articulation entre trois niveaux d’analyse rarement présentés ensemble dans une même séance : le mécanisme d’optimisation local (momentum), la question architecturale globale (dimensionnement des couches) et une variante structurelle précise (réseaux à liens fonctionnels). La démonstration du XOR par enrichissement polynomial des entrées est particulièrement pédagogique, car elle relie explicitement la non-linéarité du problème à la dimensionnalité de l’espace des caractéristiques. La mise en perspective historique des CNN, avec l’évolution conjointe de la profondeur et du nombre de paramètres, offre un repère utile pour comprendre pourquoi l’augmentation de la profondeur n’implique pas nécessairement celle du coût paramétrique.
Pour aller plus loin :
- Réseau de neurones artificiels — Vue d’ensemble des architectures et des règles d’apprentissage évoquées dans la séance.
- Descente de gradient stochastique — Contexte formel du SGD et de ses variantes avec momentum.
- Théorème d’approximation universelle — Fondement théorique de l’affirmation sur les réseaux multicouches comme approximateurs universels.
- Réseau de neurones convolutif — Détail des architectures LeNet, AlexNet, VGG et Inception citées.
- Perceptron multicouche et séparabilité linéaire — Notion directement liée à la démonstration du XOR par extension de caractéristiques.
202 mots
Profil radar
Le profil est équilibré autour de valeurs moyennes : la quantité et la qualité de l'information, le niveau technique et la fiabilité globale se situent tous à 6/10. Ce profil correspond à un cours universitaire de niveau intermédiaire, riche en concepts mais pauvre en références explicites. Le point faible est l'absence totale de sources citées, compensée par l'exactitude globale des notions présentées.