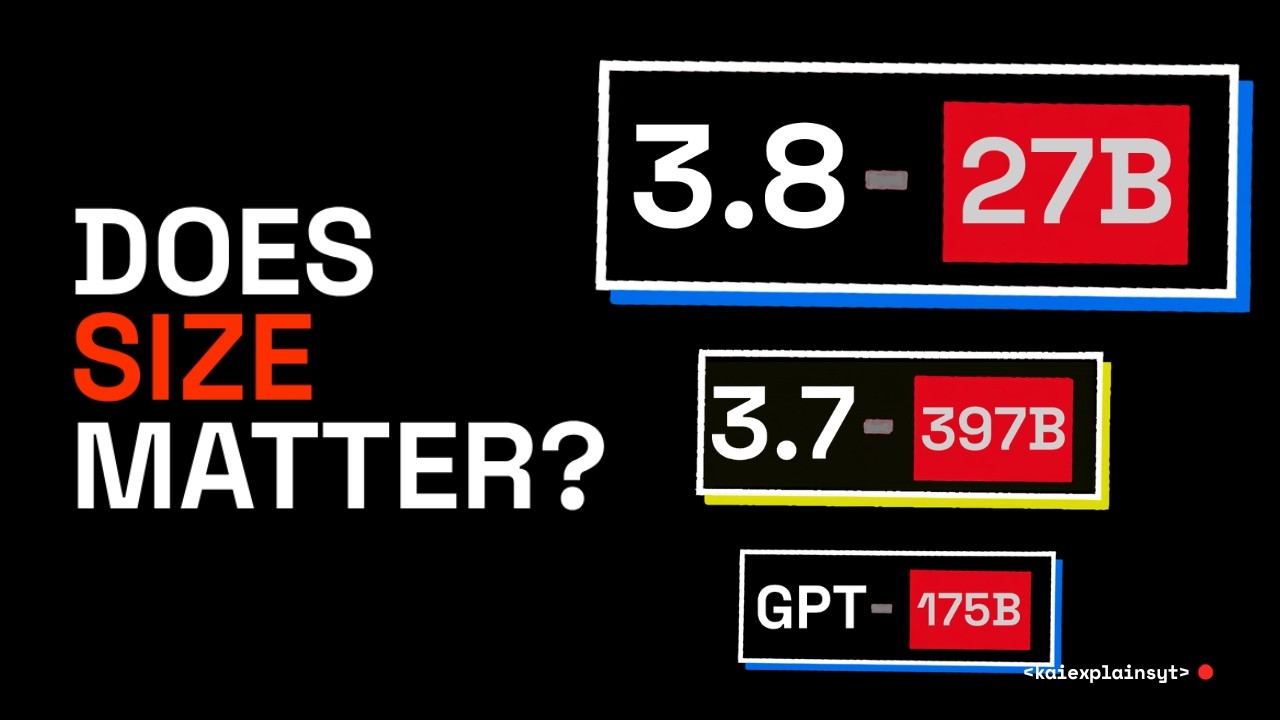
How AI Got Smaller And Still Became Smarter
Comment l'IA est devenue plus petite et est devenue plus intelligente
Historique des titres
- How AI Got Smaller And Still Became Smarter — observé le 20261031-2330 UTC (YouTube)
Mots-clés
Résumé
230 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La vidéo apporte une valeur indéniable en clarifiant les notions souvent confondues de paramètres actifs et totaux, et en révélant les coûts cachés liés au cache de contexte et aux réglages de raisonnement. L’argumentation repose sur des exemples concrets (Chinchilla, Qwen, DeepSeek) et une métaphore pédagogique du restaurant. La démonstration est logique et progressive, mais quelques points mériteraient davantage de sources chiffrées (ex. les coûts réels de l’API). Le ton est critique et invite à la prudence, ce qui renforce la crédibilité. Toutefois, l’auteur ne fournit pas toutes les données sources, certaines statistiques (comme le nombre de tests communautaires) restent vagues.
Rigueur scientifique, qualité des sources, adéquation du titre
La vidéo est généralement rigoureuse dans ses explications techniques, mais les sources citées sont principalement des vidéos liées dans la description, sans référence directe à des papiers scientifiques. L’auteur mentionne des travaux (Chinchilla, GPT-3) sans donner de liens. La comparaison des benchmarks est présentée avec nuance, mais le contexte des tests est explicitement rappelé. L’adéquation titre/contenu est bonne, bien que le titre soit à double sens : il évoque une évolution positive, alors que la vidéo montre que la promesse de réduction n’est que partielle. La qualité globale est satisfaisante, mais une transparence accrue sur les sources serait un plus.
216 mots
Adéquation titre / contenu
Le titre reflète bien le thème central : l'évolution de la taille des modèles gourmands en ressources. La vidéo démontre que la réduction annoncée des paramètres masque des coûts cachés, ce que le titre suggère sans l'exploiter pleinement.
Qualité & fiabilité
8/10
Le contenu est globalement fiable, appuyé sur des exemples concrets et des données publiques, mais certaines comparaisons (équité des benchmarks) sont présentées avec une nuance critique. Quelques approximations mineures dans les chiffres, mais l'ensemble est rigoureux.
Chapitres
Sources citées
- Deepseeks's New v4.1 Flash — Vidéo liée dans la description, présentée comme un complément sur les modèles récents.
- What is Cost to Run Deepseek V4.1 Flash Locally — Vidéo liée dans la description, détaillant les coûts d'exécution locale.
Apport & nouveautés
La vidéo apporte un éclairage original sur la distinction entre paramètres actifs et totaux, et sur le coût réel du contexte (KV cache). Elle fournit des conseils pratiques pour interpréter les annonces de modèles et ajuster les paramètres de raisonnement. Ce contenu est utile pour les utilisateurs de LLM soucieux des coûts.
Pour aller plus loin :
- Mixture of experts — Cette architecture est au cœur de la réduction des paramètres actifs ; la page détaille le fonctionnement et les variantes.
- Chinchilla (language model) — L’étude de DeepMind sur l’équilibre entre taille du modèle et volume de données, citée dans la vidéo, est expliquée ici.
- Transformer (machine learning model) — La notion de cache de clé-valeur (KV cache) s’inscrit dans les mécanismes d’attention ; cette page donne une vue d’ensemble.
130 mots
Profil radar
Le profil radar montre une forte fiabilité et une bonne quantité d'informations, une qualité technique correcte mais non maximale, et une fiabilité globale bonne. Cela indique une vidéo informative et équilibrée, avec quelques réserves sur la profondeur technique.