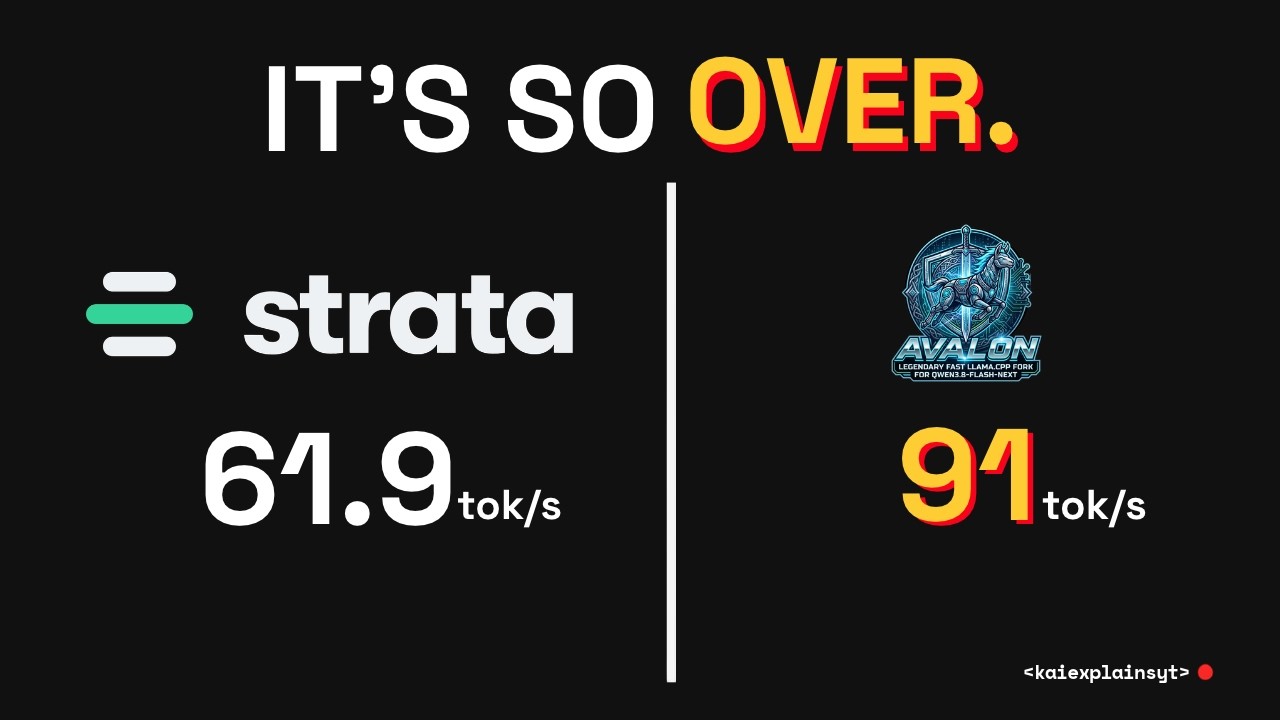
Avalon Just Beat Strata by 47% on AMD (9x Faster)
Avalon vient de battre Strata de 47% sur AMD (9x plus rapide)
Historique des titres
- Avalon Just Beat Strata by 47% on AMD (9x Faster) — observé le 20261031-2302 UTC (YouTube)
Mots-clés
Résumé
182 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée car la vidéo va au-delà du simple chiffre et dissèque la méthodologie du benchmark, les mécanismes techniques (cache d’experts, drafter MTP) et les biais potentiels. L’argumentation est solide : l’auteur s’appuie sur des données publiques (benchmarks des développeurs, tests de la communauté) et adopte un regard critique en montrant que le gain est dépendant du matériel. Il expose clairement les avantages et inconvénients de chaque moteur selon le usage, et fournit des recommandations pratiques. L’argumentation est cohérente et bien étayée par des calculs de bande passante et des comparaisons de versions.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est remarquable : l’auteur vérifie les dates de version, les notes de mise à jour, et cite explicitement les sources (README, releases GitHub, benchmarks communautaires). Il identifie une erreur factuelle (date du CPU) et corrige. Les sources sont de première main (dépôts officiels, tests d’utilisateurs) et la méthode est transparente. L’adéquation titre/contenu est bonne : le titre annonce le gain de 47%, et la vidéo explique précisément d’où il vient et ses conditions de validité, sans exagération. Aucune publicité n’est présente dans la description ni dans la vidéo.
203 mots
Adéquation titre / contenu
Le titre est accrocheur mais exact : la vidéo confirme le gain de 47% sur la carte 7900 XT et explique le contexte, même si '9x' n'est pas mentionné tel quel dans la vidéo.
Qualité & fiabilité
9/10
Analyse rigoureuse et transparente : la vidéo détaille la méthodologie du benchmark (même machine, même soir, median de 3 essais), distingue les gains moteur et draft, et identifie clairement les limites (versions logicielles, fichiers modèles différents, matériel spécifique). L'auteur n'hésite pas à nuancer les résultats selon le matériel et à citer les sources critiques.
Chapitres
- 61.9 to 91 on a 2020 desktop
- Why it reads as revenge
- A fork built for one model
- A €500 card in a 2020 box
- 125B counted, 177B stored
- The RAM floor and the cache
- Every byte of VRAM is cache
- 47% is two numbers
- Drafting on a mixture of experts
- Faster on a bigger file
- The Strata build from that night
- The card Strata never ran
- 61.9 is what owners get
- Off the home card, it shrinks
- 32 gigs and the prompt bill
- The owner this is wrong for
- Run what your card's author runs
Sources citées
- Avalon README — Source principal du benchmark : contient les tableaux de comparaison, les spécifications matérielles, et les tests supplémentaires (32 Go, RTX 4090).
- Avalon model files et recette de quantification — Fichiers GGUF utilisés pour le modèle Qwen3.8-Flash-Next dans Avalon.
- Avalon issue #1 (test W7800) — Rapport d'utilisation de deux Radeon Pro W7800 avec résultats de performance.
- Avalon launch thread sur r/ROCm — Fil de discussion initial sur Reddit, avec commentaires du développeur.
- Strata (dépôt GitHub) — Moteur d'inférence concurrent, avec documentation et code source.
- Strata releases — Notes de version incluant les améliorations AMD et les mentions de RDNA 4.
- Strata AMD support table — Tableau de support matériel et historique du backend HIP.
- Strata community benchmarks — Résultats de benchmarks fournis par les utilisateurs sur différentes cartes (7900 XT, XTX, GRE, etc.).
- Strata vs llama.cpp head-to-head sur RTX 3060 — Benchmark du 6 octobre 2026 comparant Strata à llama.cpp, source de la comparaison historique.
- llama.cpp PR #30971 (MoE offload) — Tentative d'intégration d'un offload adaptatif MoE dans llama.cpp, liée aux améliorations d'Avalon.
- llama.cpp PR #30966 (missed experts CPU) — PR pour gérer les experts manquants sur CPU en parallèle, même esprit qu'Avalon.
- Prix utilisé RX 7900 XT (EU) — Historique des prix d'occasion de la carte utilisée dans le benchmark.
Apport & nouveautés
L’apport original de cette vidéo est d’expliquer en profondeur pourquoi un moteur d’inférence dépasse un autre sur une carte AMD, en décomposant les gains en facteurs techniques (cache d’experts, draft efficace) et en montrant que le résultat dépend fortement du matériel cible. Elle fournit une méthodologie pour lire tout benchmark d’inférence LLM, en insistant sur la nécessité de connaître la version exacte, le fichier modèle, la configuration matérielle complète et le propriétaire du matériel. Cet éclairage est précieux pour la communauté des utilisateurs de cartes AMD qui cherchent à maximiser les performances en local.
Pour aller plus loin :
- Mixture of experts — Architecture du modèle Qwen3.8-Flash-Next, essentielle pour comprendre le cache d’experts et le calcul mémoire.
- ROCm — Stack logiciel AMD pour le calcul GPU, au cœur des performances sur les cartes Radeon.
- Speculative execution — Concept général sous-jacent au speculative decoding utilisé par Avalon et Strata.
148 mots
Profil radar
Le profil radar montre un niveau très élevé sur tous les axes (quantité, qualité, technique, fiabilité), indiquant une analyse approfondie et fiable, avec une légère baisse sur la fiabilité en raison de la dépendance à des sources non vérifiées par le créateur (benchmarks de développeurs).