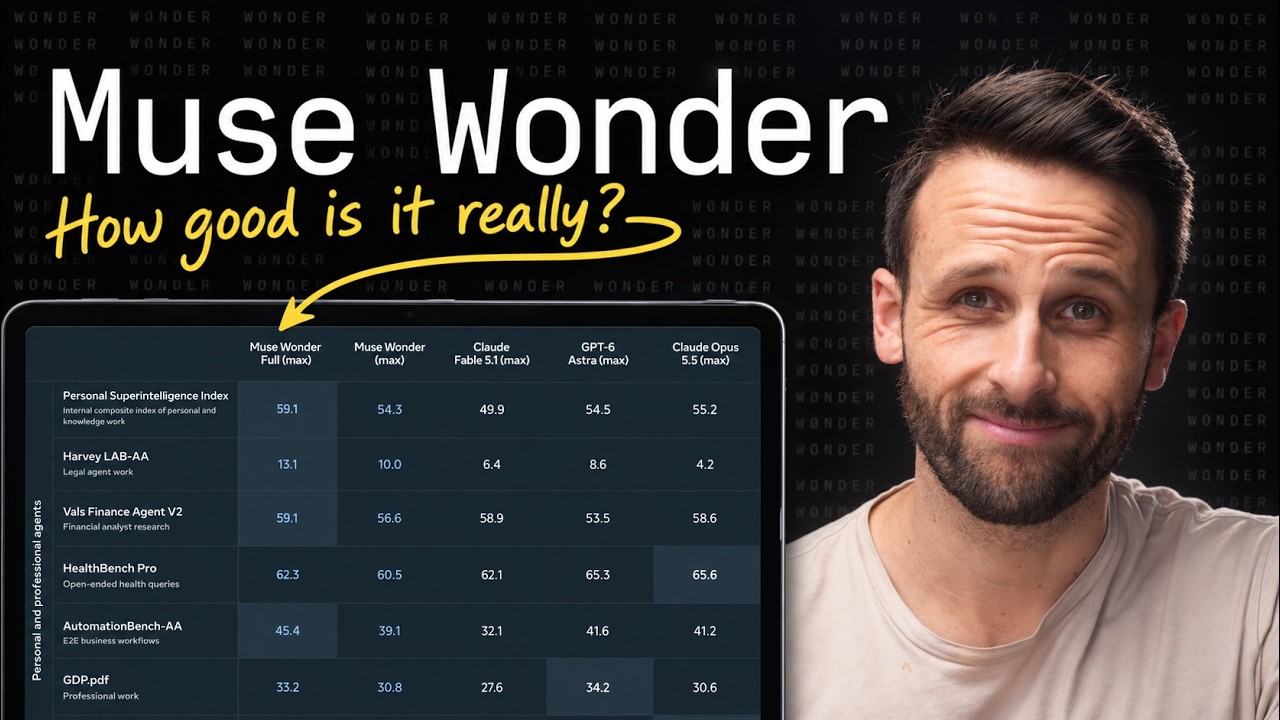
Muse Wonder: No Hype Full Review & Testing
Muse Wonder : Test et avis complet sans langue de bois
Mots-clés
Résumé
205 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La vidéo offre une valeur certaine en fournissant des tests pratiques et reproductibles sur un nouveau modèle d’IA, avec des comparaisons directes sur diverses tâches. L’argumentation est solide dans la mesure où les tests sont décrits en détail, les conditions d’accès et les coûts sont exposés, et les résultats sont présentés avec des exemples concrets. Le créateur utilise sa propre méthodologie (Simmons Bench) et une skill de clonage, ce qui donne une vision pragmatique des capacités du modèle. Cependant, on note une subjectivité dans les commentaires (par exemple, le rejet de certains choix de Meta) et une dépendance à des benchmarks potentiellement biaisés. L’argumentation est globalement convaincante mais non sans faille, car elle repose en partie sur des impressions personnelles plutôt que sur des métriques standardisées.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est moyenne : le créateur s’appuie sur des benchmarks publics (Artificial Analysis, SWE-bench, etc.) mais ne cite pas les sources primaires directes. Il mentionne des données de coûts issues de sa propre expérience et de celle d’autres utilisateurs, sans vérification indépendante. La qualité des sources est donc limitée, bien que les liens vers son blog fournissent des détails supplémentaires. L’adéquation titre/contenu est bonne : le titre promet une revue sans exagération, et la vidéo tient cette promesse en montrant les résultats, y compris les échecs. On note également une demande d’abonnement et de partage, ce qui est courant, mais n’affecte pas la fiabilité du contenu.
249 mots
Adéquation titre / contenu
Le titre annonce une revue et des tests, ce qui correspond au contenu.
Qualité & fiabilité
8/10
Le test est rigoureux, avec des benchmarks et des essais pratiques comparatifs, mais repose sur une méthodologie personnelle et des opinions subjectives.
Chapitres
Sources citées
- Blog post: Muse Wonder full review and costs — Source de référence pour les prompts et les coûts détaillés.
Références externes
Apport & nouveautés
Cette vidéo apporte un éclairage pratique sur les capacités réelles de Muse Wonder, au-delà des benchmarks marketing. Elle met en évidence les forces du modèle dans les tâches de type agent personnel et ses faiblesses en matière de reproduction de site, tout en soulignant les problèmes de quotas et de coûts réels. L’approche comparative et les tests concrets constituent une valeur ajoutée pour les développeurs souhaitant évaluer ce modèle.
Pour aller plus loin :
- Benchmark (informatique) — Pertinence : comprendre les métriques utilisées pour évaluer les modèles.
- Meta (entreprise) — Pertinence : contexte de l’éditeur et positionnement du modèle.
- Agent intelligent — Pertinence : les agents IA mentionnés dans la vidéo.
111 mots
Profil radar
Le profil radar montre une quantité d'informations élevée mais une fiabilité modérée, reflétant une démarche empirique mais peu de sources externes vérifiées. La qualité et le niveau technique sont bons, ce qui indique une adaptation au public averti.