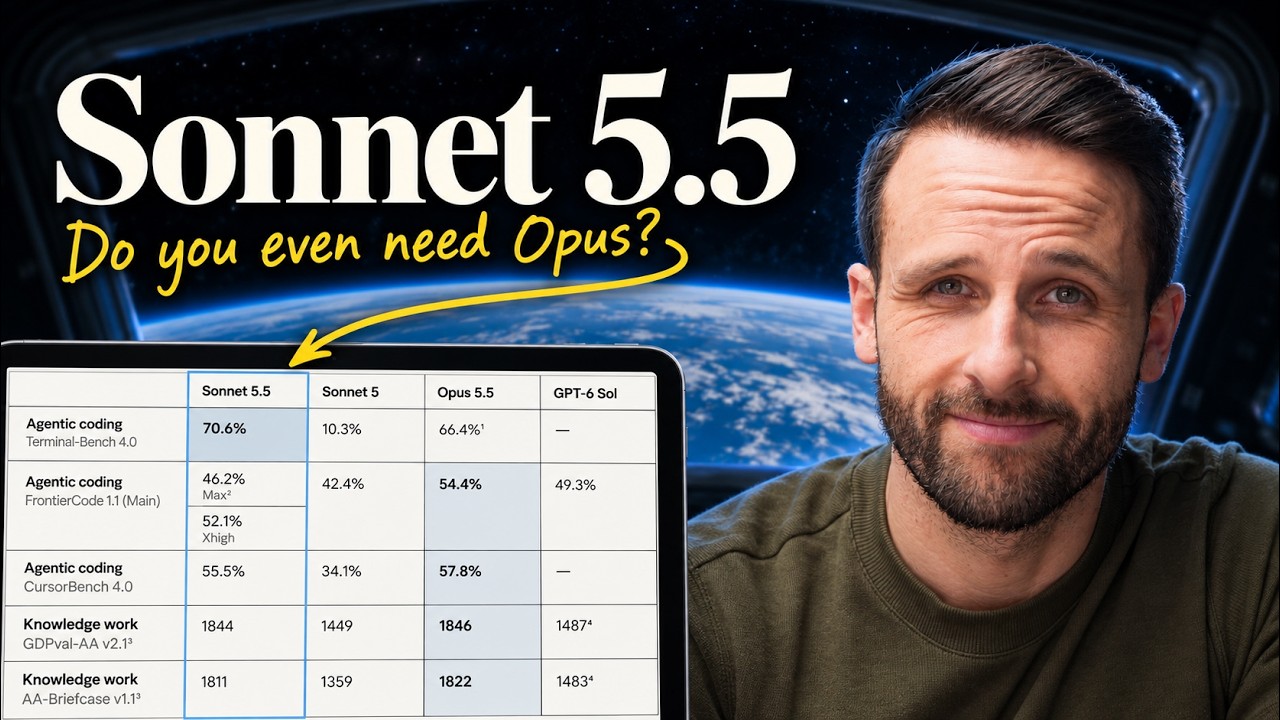
Sonnet 5.5: No-Hype Full Review & Testing
Sonnet 5.5: Revue complète sans battage et tests
Mots-clés
Résumé
180 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La vidéo apporte une valeur significative par son approche empirique : elle teste réellement les modèles sur des projets concrets et mesure des métriques objectives (coûts, temps, tokens). L’argumentation est structurée : chaque test est décrit, les résultats sont présentés à l’aveugle, puis les coûts sont analysés. L’auteur nuance les benchmarks officiels en les confrontant à des sources externes comme Artificial Analysis, et discute des limites liées aux niveaux d’effort. Cette analyse concrète aide le spectateur à comprendre les compromis réels entre modèles.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est satisfaisante : l’auteur cite les benchmarks d’Anthropic, mais aussi des analyses indépendantes, et fournit ses propres données issues de tests reproductibles. La description contient des liens vers un article de blog détaillé avec prompts et tableaux, ce qui renforce la transparence. Le titre, ‘No-Hype Full Review & Testing’, est bien respecté : l’auteur adopte un ton critique et mesuré, sans exagération. Il reconnaît les points forts et faibles de chaque modèle. Les sources citées sont principalement les documents de l’auteur, ce qui limite l’indépendance, mais la démarche reste honnête.
191 mots
Adéquation titre / contenu
Le titre annonce un test complet sans exagération ; le contenu correspond : benchmarks, tests réels, coûts, verdict.
Qualité & fiabilité
8/10
Test comparatif réel avec mesure de coûts, de temps et de tokens, reposant sur des benchmarks publics et des tests pratiques. L'auteur explicite sa méthode et fournit les prompts et résultats dans un article de blog.
Chapitres
Sources citées
- Article de blog de l'auteur pour Sonnet 5.5 — Contient les prompts, les détails des tests et les tableaux de coûts.
- Newsletter AI for Mortals — Abonnement à la newsletter de l'auteur.
Sources concordantes
- Article de blog de l'auteur — Source détaillant les tests et résultats, cohérente avec la vidéo.
Apport & nouveautés
L’apport de cette vidéo est de fournir un test pratique et comparatif de Sonnet 5.5 face à d’autres modèles de pointe, avec des mesures concrètes de coûts, de tokens et de temps sur des projets réalistes (vidéo de lancement, site web 3D, jeu d’horreur). L’auteur utilise des benchmarks publics et ses propres tests pour évaluer les performances réelles, et discute des nuances liées aux niveaux d’effort et aux coûts. Il met en avant la possibilité d’utiliser Sonnet 5.5 comme alternative économique à Opus 5.5 dans de nombreux scénarios.
Pour aller plus loin :
- Anthropic — Notes sur l’entreprise derrière Sonnet 5.5.
- Claude (language model) — Informations sur les modèles Claude.
- Benchmark (computing) — Le concept de benchmark appliqué à l’IA.
120 mots
Profil radar
Le profil radar montre une évaluation équilibrée, avec une bonne quantité d'informations, une qualité élevée, un niveau technique soutenu et une fiabilité correcte, reflétant un test rigoureux mais personnel.