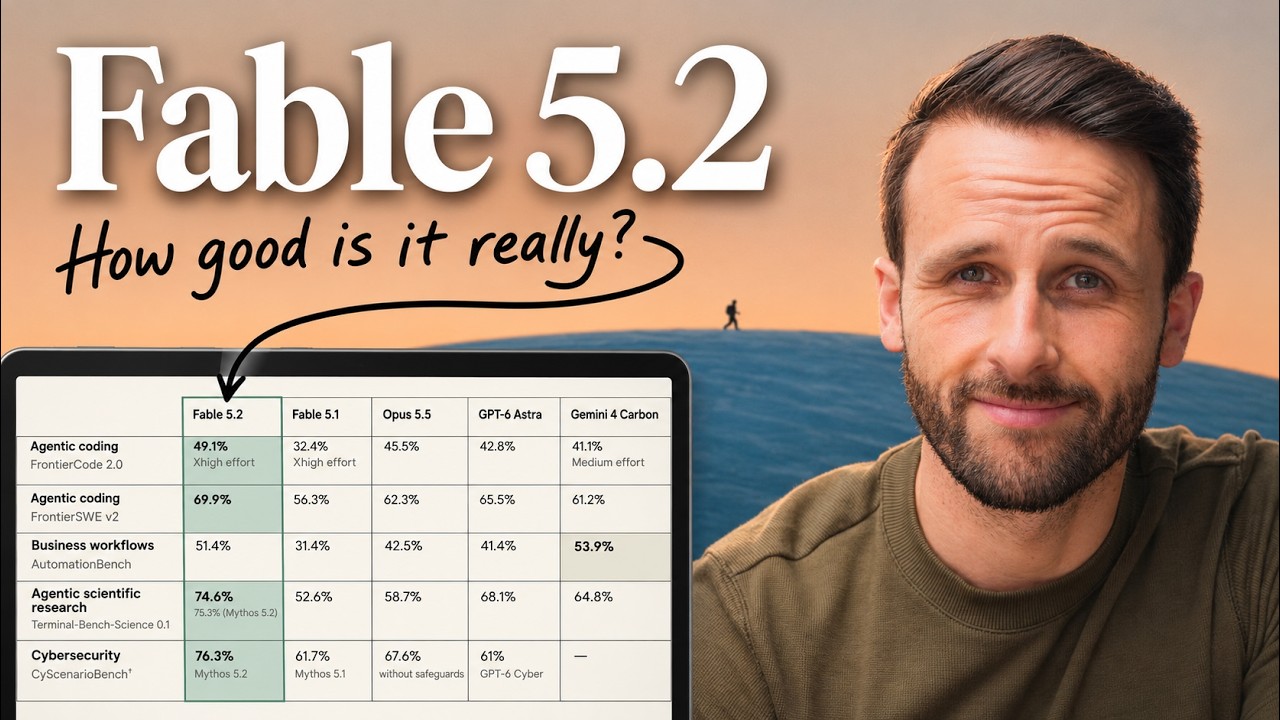
Fable 5.2: NO-HYPE Full Review (& Testing)
Fable 5.2 : Critique complète sans exagération (et tests)
Historique des titres
- Fable 5.2: NO-HYPE Full Review (& Testing) — observé le 20261110-0839 UTC (YouTube)
Mots-clés
Résumé
158 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations réside dans les tests pratiques et comparatifs, avec des mesures concrètes de temps, de tokens et de coûts. Le créateur détaille les performances de chaque modèle sur trois types de tâches (création vidéo, 3D, développement web), ce qui donne une indication utile pour les développeurs. L’argumentation est solide : il appuie ses observations sur des données chiffrées et des exemples visuels. Cependant, il exprime aussi des opinions subjectives sur la qualité des résultats (ex. ’le meilleur 3D’, ’la narration est meilleure’) sans critères objectifs formels. La démonstration est globalement convaincante, mais elle manque d’une méthodologie rigoureuse pour quantifier les différences qualitatives.
Rigueur scientifique, qualité des sources, adéquation du titre
Le créateur cite les benchmarks officiels d’Anthropic et renvoie à son propre blog pour les prompts et coûts détaillés. Il ne fournit pas de sources scientifiques indépendantes, mais s’appuie sur des données factuelles recueillies lors de ses tests. L’adéquation titre/contenu est bonne : le titre promet une revue sans hype, et le contenu est effectivement critique, signalant les points faibles (ex. la qualité des films générés). La rigueur scientifique est moyenne : les tests sont reproductibles (il donne les prompts), mais l’évaluation reste qualitative. Les commentaires sur la précision historique des rendus (ex. Central Park) sont laissés ouverts, invitant les spectateurs à confirmer.
223 mots
Adéquation titre / contenu
Le titre correspond bien au contenu : une revue complète avec des tests réels et une analyse des benchmarks.
Qualité & fiabilité
7/10
Le créateur réalise des tests concrets et comparatifs, mais s'appuie fortement sur les benchmarks officiels d'Anthropic sans vérification indépendante complète. Les coûts et durées sont mesurés, mais l'évaluation de la qualité des builds reste subjective.
Chapitres
Sources citées
- Blog post sur Fable 5.2 (builds, prompts, coûts) — Fournit les prompts complets, les captures d'écran et les coûts détaillés des builds.
- Abonnement à la newsletter AI for Mortals — Permet de recevoir des conseils et builds quotidiens.
Apport & nouveautés
Cette vidéo apporte une évaluation indépendante et chiffrée du nouveau modèle Fable 5.2, avec des tests sur des cas concrets (3D, vidéo, web) et une comparaison directe avec les principaux concurrents. Elle met en évidence le rapport coût/performance, un élément crucial pour les développeurs. L’originalité réside dans la méthode de test : des builds complets plutôt que des benchmarks isolés, ce qui reflète des usages réels.
Pour aller plus loin :
- Claude (modèle d’IA) — Contexte sur la famille de modèles d’Anthropic, dont fait partie Fable 5.2.
- Artificial Analysis — Plateforme indépendante de comparaison de modèles d’IA, utile pour vérifier les performances.
- Agentic AI — Concept d’agents autonomes, pertinent pour comprendre les applications de Fable 5.2.
116 mots
Profil radar
Le profil radar montre une excellente quantité d'information et un niveau technique élevé, mais une fiabilité globale plus faible, reflétant le caractère subjectif de certaines évaluations. La qualité de l'information est bonne, malgré une dépendance aux benchmarks officiels.