NLP: Self-supervised Models (or: "How to grow language models") - Lecture 5 - Fall 2026
NLP : Modèles auto-supervisés (ou : « Comment faire grandir les modèles de langue ») - Cours 5 - Automne 2026
Mots-clés
Résumé
170 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur de ce cours réside dans sa rigueur pédagogique : il ne se contente pas d’énoncer l’algorithme, mais le construit étape par étape en justifiant chaque choix. L’argumentation s’appuie sur des dérivations formelles, des vérifications de dimensions et une analyse de complexité comparative. La démonstration de la nécessité de la règle de chaîne et de la programmation dynamique est particulièrement solide, car elle motive clairement la transition d’une complexité quadratique à linéaire. L’approche interactive, avec des questions posées aux étudiants, permet de clarifier les points subtils et de renforcer la compréhension conceptuelle.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est exemplaire : le contenu est conforme aux fondements des réseaux de neurones, avec une distinction nette entre ce qui est démontré et ce qui est admis. La qualité des sources est bonne, même si la vidéo ne cite pas directement de références bibliographiques ; la page du cours fournie en description est la source institutionnelle pertinente. L’adéquation entre le titre et le contenu est bonne : le titre mentionne les modèles auto-supervisés et la leçon porte bien sur l’entraînement par rétropropagation, qui en est le fondement. Aucun commentaire n’étant disponible, aucune analyse du public n’est possible.
208 mots
Adéquation titre / contenu
Le titre indique bien le sujet : les modèles auto-supervisés en NLP, et la partie sur l'apprentissage des modèles de langage. La conférence porte effectivement sur l'apprentissage par rétropropagation pour ces modèles.
Qualité & fiabilité
9/10
Exposé magistral rigoureux, avec dérivations mathématiques pas à pas, interaction avec les étudiants et démonstration de la complexité algorithmique. Les concepts sont présentés de manière structurée et pédagogique, avec des vérifications de dimensions et une clarté didactique élevée.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction : mise en place du problème d'entraînement des réseaux de neurones.
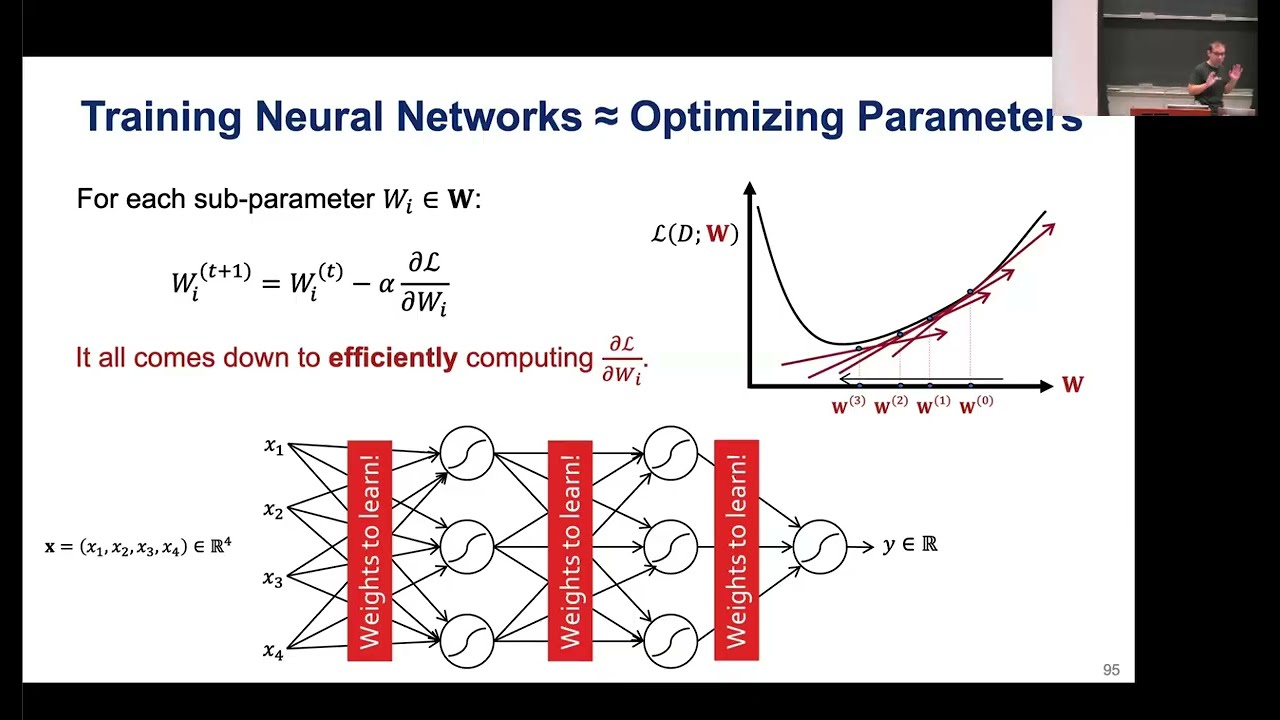
- Définition de la fonction de perte et principe de la descente de gradient.
- Formalisation du réseau de neurones : notations et calcul de la complexité du passage avant.
- Dérivation des gradients par la règle de chaîne et introduction aux Jacobiens.
- Optimisation par programmation dynamique : définition des deltas et réduction de la complexité à linéaire.
- Présentation complète de l'algorithme de rétropropagation et conclusion.
Sources citées
- Page du cours Self-supervised — Page officielle du cours, fournie dans la description de la vidéo.
Apport & nouveautés
L’apport principal est une explication pédagogique de la rétropropagation qui met l’accent sur la motivation algorithmique : le passage d’une complexité quadratique à linéaire grâce au principe de programmation dynamique. La présentation des variables delta et la vérification dimensionnelle des tenseurs constituent une approche claire et originale.
Pour aller plus loin :
- Rétropropagation du gradient - Wikipédia — Concept fondamental, avec historique et applications.
- Deep Learning Book — Référence complète sur les réseaux de neurones et la rétropropagation.
- Backpropagation - Wikipédia (EN) — Explication détaillée et complémentaire.
87 mots
Profil radar
Le profil radar montre une excellente qualité et fiabilité de l'information, avec un niveau technique très élevé. La quantité d'information est légèrement inférieure, ce qui reflète un cours magistral ciblé sur la dérivation d'un algorithme précis plutôt que sur un panorama exhaustif du domaine.