CS 471/671 (How to grow language models) - #17 - Fall 2026
CS 471/671 (Comment faire grandir les modèles de langage) - n°17 - Automne 2026
Historique des titres
- CS 471/671 (How to grow language models) - #17 - Fall 2026 — observé le 20261105-2038 UTC (YouTube)
Mots-clés
Résumé
197 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations est élevée : le cours fournit des recommandations pratiques basées sur des observations empiriques et des travaux récents (comme le modèle DeepSeek). L’argumentation est claire, progressive, et s’appuie sur des exemples concrets (le cas des documents de ’m’, les graphiques de loss). L’enseignant expose les compromis et les questions ouvertes, ce qui renforce la crédibilité de l’exposé. La démonstration du code PyTorch pour l’accumulation de gradients est didactique et facilite la compréhension.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est satisfaisante pour un cours : les concepts sont expliqués avec précision et les références à la littérature existante (DeepSeek, BERT) sont mentionnées, bien qu’elles ne soient pas systématiquement accompagnées d’URLs. La qualité des sources est inégale : le cours ne fournit qu’un lien vers la page du module, ce qui limite la vérifiabilité. L’adéquation titre/contenu est parfaite : le titre annonce clairement une formation sur la croissance des modèles de langage, et le contenu couvre exactement cela. Aucun commentaire n’a été fourni, donc aucune analyse des tendances du public n’est possible.
186 mots
Adéquation titre / contenu
Le titre 'How to grow language models' correspond parfaitement au contenu, qui traite des aspects pratiques et empiriques de l'entraînement et de l'adaptation de modèles de langage.
Qualité & fiabilité
8/10
Cours universitaire technique dispensé par un expert, avec des explications précises sur les pratiques d'entraînement des grands modèles de langage. Les références restent implicites ou limitées, mais le contenu est cohérent et fondé sur des observations empiriques.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction à la problématique du batch size et aux compromis entre vitesse et qualité.
- Explication de l'accumulation de gradients avec pseudo-code PyTorch.
- Extension à l'entraînement distribué : accumulation parallèle sur plusieurs GPU et opération all-reduce.
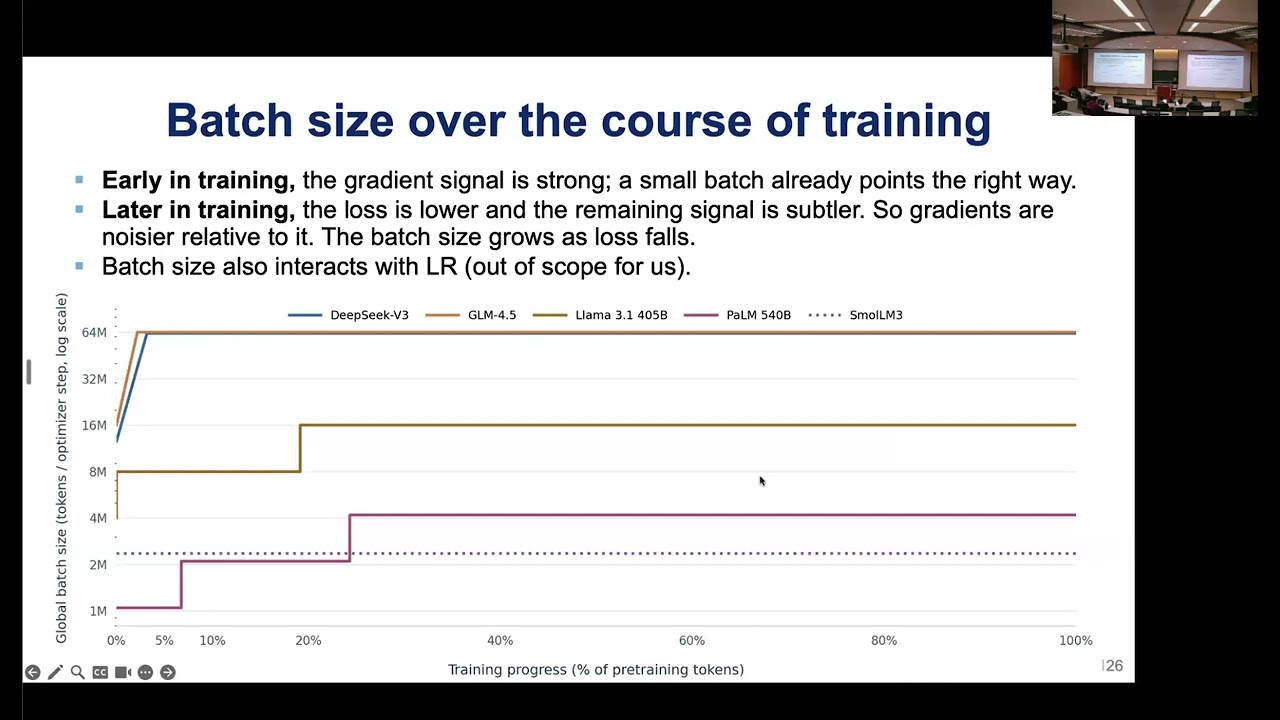
- Analyse de l'effet du batch size : tendances pour différentes tailles de modèles et budgets de calcul.
- Présentation du packing de documents pour limiter le gaspillage de calcul, et questions de masking entre documents.
- Discussion sur les epochs : changement de pratique (epoch=1 vers epoch >1) et exemple du modèle BERT.
- Transition vers l'adaptation : introduction au fine-tuning supervisé et à la définition formelle d'une tâche.
Sources citées
- Page du cours CS 471/671 - Fall 2026 — Référence à l'organisation du cours et aux ressources associées.
Apport & nouveautés
Ce cours offre une vue d’ensemble pratique et à jour des techniques d’entraînement des grands modèles de langage, en mettant l’accent sur des aspects rarement couverts dans les cours traditionnels : l’accumulation de gradients, le packing, et la gestion de la stabilité. Il apporte des recommandations concrètes issues de l’expérience et de la littérature récente (comme l’évolution des epochs). Il souligne également les questions ouvertes, ce qui invite à la réflexion critique.
Pour aller plus loin :
- Scaling laws for neural language models — Note de pertinence : relie les choix de taille de lot et d’échelle aux lois empiriques de mise à l’échelle.
- Gradient accumulation in deep learning — Note de pertinence : explique en détail les mécanismes et raisons de l’accumulation de gradients, sans garantie d’URL exacte à vérifier.
- The DeepSeek paper — Note de pertinence : référence directe utilisée dans le cours pour les recommandations sur les batch sizes et learning rates.
155 mots
Profil radar
Le profil radar montre un niveau technique élevé, compensé par une qualité d'information correcte mais non exhaustive. La fiabilité est légèrement inférieure à cause du manque de citations explicites, tandis que la quantité d'information est bonne pour un cours de cette durée.