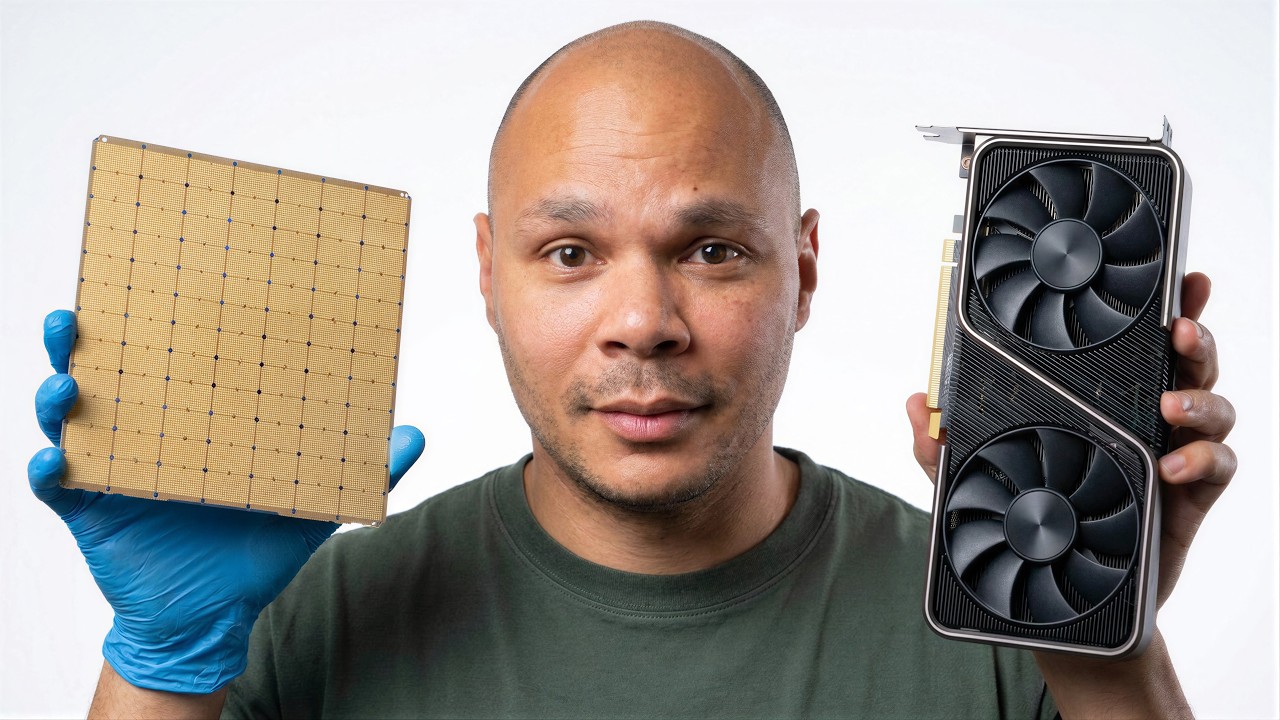
Pourquoi Nvidia a peur de ces nouvelles puces AI
Historique des titres
- Pourquoi Nvidia a peur de ces nouvelles puces AI — observé le 20261031-2318 UTC (YouTube)
Mots-clés
Résumé
174 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La valeur des informations réside dans la vulgarisation claire de concepts techniques complexes (préfill vs décodage, KV cache, SRAM, HBM, architecture systolique) et dans la comparaison chiffrée des performances (tokens/s) entre acteurs. L’argumentation est structurée : l’auteur part d’un constat, explique les causes (bande passante mémoire), puis présente successivement les solutions de Groq, Cerebras, Talaas et OpenAI. La solidité repose sur des exemples concrets et des analogies intuitives, mais certains chiffres (ex. 1700 t/s pour Cerebras) sont avancés sans source vérifiable, et les comparaisons mélangent des modèles de tailles différentes (GPT-5.6, Llama 3.3 70B). Le raisonnement est globalement cohérent, mais l’absence de citations ou de références limite la vérifiabilité.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est moyenne : la vidéo repose sur des données tirées de benchmarks ou d’annonces non sourcées, et certaines affirmations (rendements de fabrication, taux de défauts) sont approximatives. Les sources ne sont ni nommées ni citées, ni dans le discours ni dans la description (qui contient seulement des mots-clés). L’adéquation entre le titre et le contenu est bonne : le titre pose la question de la peur de Nvidia, et le contenu confronte les positions de Nvidia et de ses concurrents. Toutefois, le ton est parfois spéculatif (futur des architectures) et le manque de sources formelles empêche de qualifier le contenu de scientifique au sens strict.
232 mots
Adéquation titre / contenu
Le titre est fidèle au contenu, qui traite effectivement des nouvelles puces d'IA et de leur impact potentiel sur Nvidia.
Qualité & fiabilité
6/10
Explication vulgarisée mais techniquement instructive, avec des chiffres précis (tokens/s, capacités mémoire) mais sans sources formelles vérifiables. L'auteur maîtrise son sujet mais simplifie certains aspects et mêle des données potentiellement approximatives.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Démo de vitesse : 14 000 tokens/s sur un modèle spécialisé.
- Explication des limites des GPU pour l'inférence LLM.
- Présentation des TPU de Google et de l'architecture systolique.
- Comparaison des tokens/s : GPU ~80, TPU ~153, Groq ~300.
- Explication du préfill et du décodage, introduction du KV cache.
- Groq : solution à base de SRAM intégrée pour le décodage.
- Cerebras : méga-puce sur galette, difficultés de fabrication.
- Talaas et puces gravées pour un modèle spécifique.
- OpenAI et sa puce Jalapeno ; avantages de flexibilité de Nvidia.
Apport & nouveautés
La vidéo apporte une vue d’ensemble accessible du paysage des puces d’IA en 2026, avec une focalisation sur les solutions alternatives aux GPU pour l’inférence. Son apport original est de vulgariser les compromis entre flexibilité (GPU) et spécialisation (TPU, Groq, Cerebras, puces dédiées), et de relier ces choix à des aspects économiques (revente, obsolescence).
Pour aller plus loin :
- GPU (Wikipedia) — Pour comprendre le fonctionnement général des GPU.
- TPU (Wikipedia) — Détails sur l’architecture des TPU de Google.
- High Bandwidth Memory (Wikipedia) — Explication de la mémoire HBM évoquée pour les puces modernes.
94 mots
Profil radar
Le profil radar montre une bonne quantité d'informations et un niveau technique intermédiaire, mais une fiabilité globale faible en raison de l'absence de sources citées. La qualité de l'information est correcte pour une vulgarisation, et l'adéquation au titre est bonne.