Benchmarking Machine Learning for Climate Science | Duncan Watson-Parris | ADIA Lab Symposium 2026
Évaluation comparative de l'apprentissage automatique pour la science du climat | Duncan Watson-Parris | Symposium ADIA Lab 2026
Historique des titres
- Benchmarking Machine Learning for Climate Science | Duncan Watson-Parris | ADIA Lab Symposium 2026 — observé le 20261104-0952 UTC (YouTube)
Mots-clés
Résumé
205 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
La présentation apporte une valeur certaine en identifiant les limites des benchmarks actuels et en proposant des améliorations concrètes. L’argumentation est solide, appuyée sur des exemples précis et des résultats mesurables (scores, pourcentages). L’orateur démontre une progression logique : chaque benchmark répond à une lacune précédente. Il met en avant des leçons clés comme la saturation rapide des benchmarks et l’importance des données par rapport à l’architecture. Son raisonnement est convaincant, même si certaines transitions peuvent sembler rapides pour un public non spécialiste.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est exemplaire : l’orateur est co-auteur de ces benchmarks et cite des résultats concrets. Il reconnaît explicitement les limites (tâches difficiles, sur-ajustement) et propose des principes structurés pour des évaluations fiables. Les sources mentionnées (ClimateBench, ClimaQA, Zephyrus) sont des travaux publiés, même si aucun lien direct n’est fourni dans la description. Le titre est parfaitement adapté au contenu, qui se concentre exclusivement sur le benchmarking. Aucun commentaire public n’est fourni, donc aucune tendance n’est analysée.
176 mots
Adéquation titre / contenu
Le titre reflète exactement le contenu : le benchmarking de modèles ML pour le climat est au cœur de l'exposé.
Qualité & fiabilité
8/10
Présentation experte par un chercheur reconnu, s'appuyant sur trois benchmarks développés par son groupe et publiés. La rigueur scientifique est élevée, avec une attention particulière à l'extrapolation et aux limites des modèles. Quelques affirmations manquent de détails chiffrés, mais l'argumentation est solide.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction du contexte : les questions climatiques sont hors distribution, nécessitant une évaluation de l'extrapolation.
- Présentation de ClimateBench et découverte que les modèles linéaires surpassent les réseaux profonds par manque de données.
- Présentation de ClimateBench 2 avec un protocole en trois niveaux, incluant des tests d'extrapolation sur le paléoclimat.
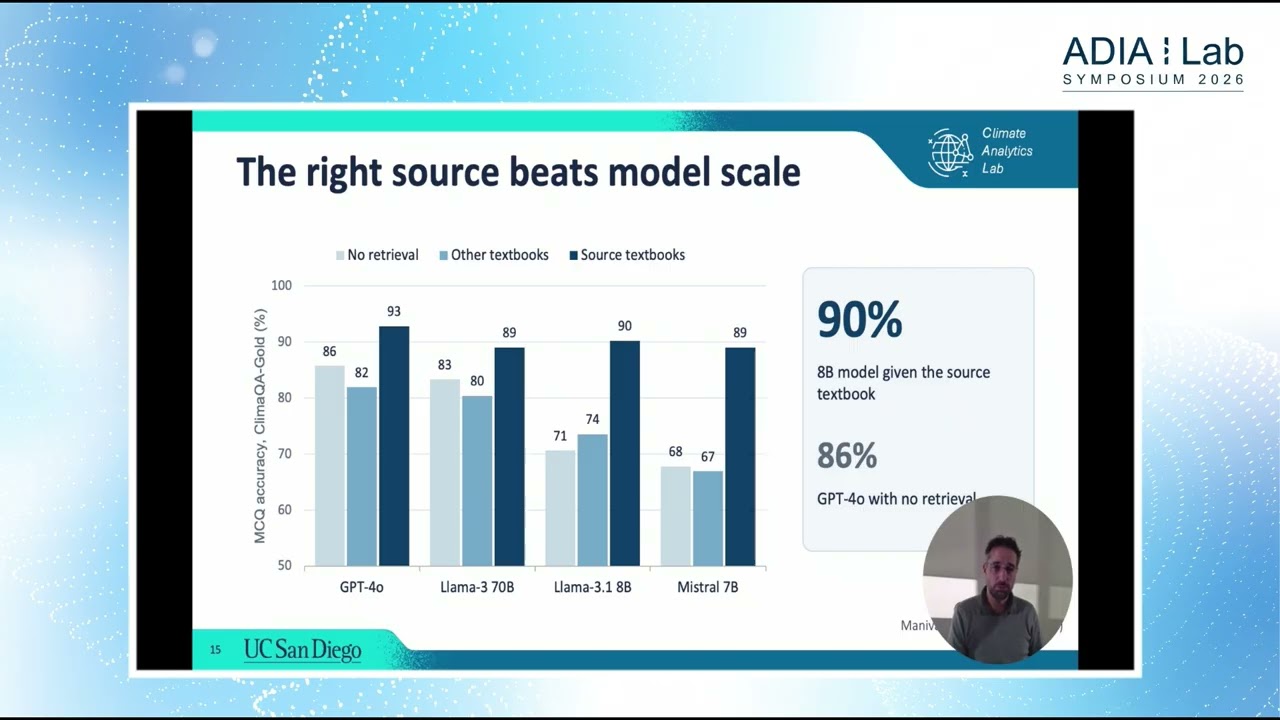
- ClimaQA : test des LLMs sur des connaissances climatiques de niveau graduate, résultats montrant que la récupération améliore les modèles open source.
- Zephyrus : agents IA pour l'analyse météo, amélioration de 28-44 points avec outils et données, mais les tâches difficiles restent à 14-15%.
- Six principes de conception pour de futurs benchmarks, soulignant l'importance de les maintenir à jour comme des infrastructures.
Sources citées
- Symposium 2026 ADIA Lab — Page de l'événement où la présentation a eu lieu.
Apport & nouveautés
L’apport original réside dans la consolidation de trois benchmarks interdépendants qui évaluent différents aspects de l’IA pour le climat : émulation, connaissances et raisonnement d’agents. L’auteur propose une évolution méthodologique en passant d’évaluations in-distribution à des tests d’extrapolation physique, et insiste sur la nécessité de benchmarks vivants. Cette approche systémique est novatrice en climatologie.
Pour aller plus loin :
- ImageNet — Benchmark emblématique ayant stimulé la révolution de l’IA, référence citée par l’auteur comme modèle à suivre.
- ClimateBench — Concept de benchmark pour émulateurs climatiques, sans URL vérifiée, mais pertinent pour approfondir.
- ERA5 — Réanalyse météorologique utilisée dans WeatherBench 2 et Zephyrus, base de données cruciale pour l’évaluation.
108 mots
Profil radar
Le profil radar montre une excellente quantité d'informations et un niveau technique élevé, tandis que la fiabilité globale reste très bonne. L'équilibre entre les scores indique une présentation dense et rigoureuse, adaptée à un public scientifique.