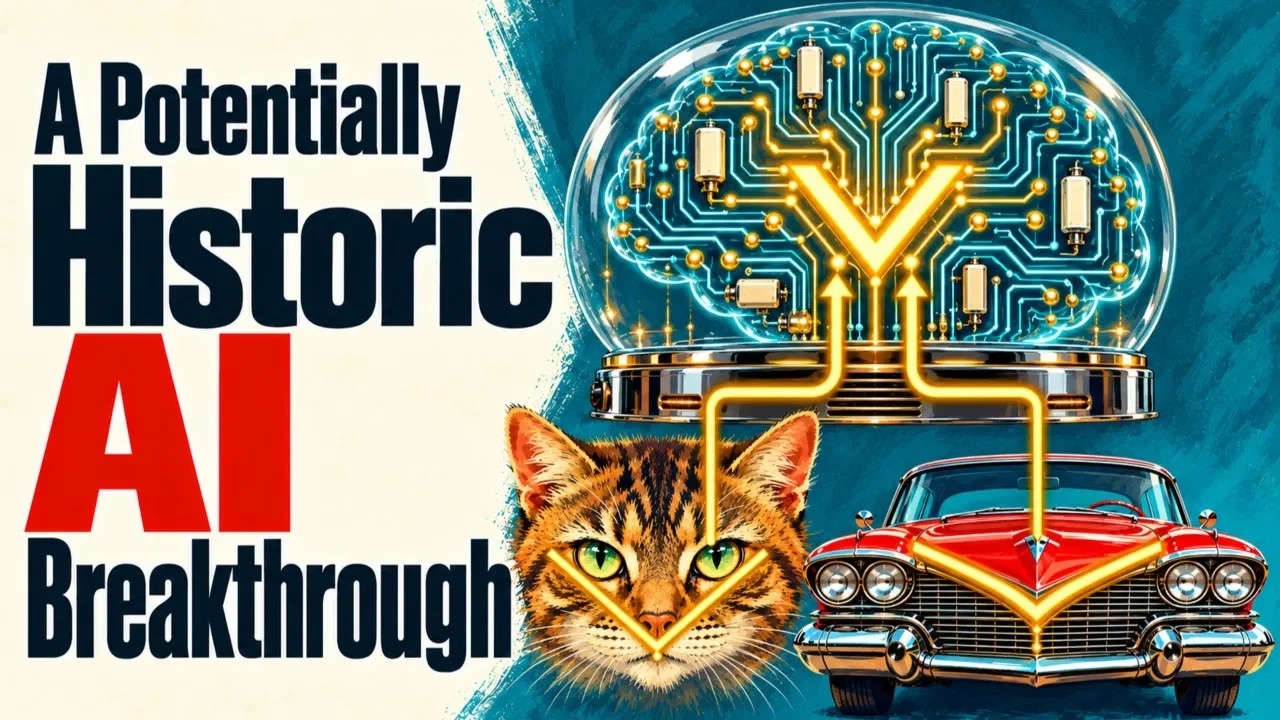
A Potentially Historic AI Breakthrough
Une percée potentiellement historique dans l'IA
Mots-clés
Résumé
188 mots
Évaluation critique
Valeur des informations & solidité de l’argumentation
L’épisode fournit une synthèse didactique d’un article scientifique dense, en le vulgarisant sans le trahir. L’argumentation est structurée : présentation du contexte, exposé de la thèse de Cammarata, analyse des exemples probants, puis confrontation avec les objections des autres chercheurs. La valeur informative est élevée pour qui s’intéresse à l’interprétabilité des réseaux de neurones, car elle met en avant des concepts clés comme la superposition, le branchement et les détecteurs. La solidité de l’argumentation est correcte : l’animateur ne prend pas position de manière tranchée, il rapporte les points de vue et précise ce qui reste à vérifier.
Rigueur scientifique, qualité des sources, adéquation du titre
La rigueur scientifique est satisfaisante : l’épisode cite les sources principales (l’essai de Cammarata, les réactions de Liv Boote, de Neel Nanda) sans fournir d’URL explicites. Les sources citées dans la description sont les sites officiels du podcast et le lien du podcast, mais pas les articles originaux. Le titre est bien en adéquation avec le contenu, même si certains aspects sont exagérés. L’absence de commentaires ne permet pas d’évaluer la tendance du public.
187 mots
Adéquation titre / contenu
Le titre est approprié : la vidéo développe bien l'idée d'une percée potentiellement historique dans le domaine de l'interprétabilité.
Qualité & fiabilité
7/10
L'épisode synthétise un essai technique majeur de Nick Cammarata et présente de manière équilibrée les réactions positives et critiques de la communauté. La fiabilité est bonne, mais repose essentiellement sur des dires non encore validés par des publications complètes.
Moments clés
Repères établis par PSI à partir de la transcription : le créateur n'a pas défini de chapitres.
- Introduction sur les craintes liées à l'IA et présentation de l'essai de Nick Cammarata.
- Explication du problème de l'interprétabilité et de la nécessité de comprendre les modèles.
- Analyse de l'exemple du détecteur de chats/voitures et découverte du détecteur de forme en V.
- Présentation des trois erreurs méthodologiques : outils flous, anciens modèles, et branchement.
- Discussion sur la plus grande lisibilité des modèles plus grands et sur les implications pour la détection de la tromperie.
- Réactions critiques de chercheurs, notamment Liv Boote et Neel Nanda, et débats sur la superposition.
- Questions ouvertes et conclusion : l'essai reste à confirmer, mais il a relancé la recherche en interprétabilité.
Sources citées
- The AI Daily Brief — Site officiel du podcast, mentionné dans la description.
- Podcast version — Lien d'abonnement au podcast, mentionné dans la description.
Apport & nouveautés
L’épisode apporte une vulgarisation accessible d’un article de recherche novateur, qui propose une remise en cause profonde de la manière dont les chercheurs perçoivent l’interprétabilité des réseaux de neurones. Il met en lumière des concepts comme le branchement et l’importance des outils d’observation. L’apport principal est de rendre compréhensible une avancée potentiellement majeure pour la communauté IA.
Pour aller plus loin :
- Mechanistic interpretability — Concept central de l’essai, qui vise à lire les réseaux de neurones comme du code.
- Superposition in neural networks — Théorie que Nick Cammarata remet en cause, expliquant que les détecteurs peuvent être partagés entre différentes idées.
- Attention Is All You Need — Article fondateur des transformers, cité en référence dans l’épisode comme comparable en importance potentielle.
122 mots
Profil radar
Le profil radar est équilibré, avec des scores modérés en quantité et qualité d'information, un niveau technique correct, et une fiabilité notable. Cela reflète un contenu informatif et bien documenté, mais qui reste une synthèse de travaux en cours et non une source primaire.