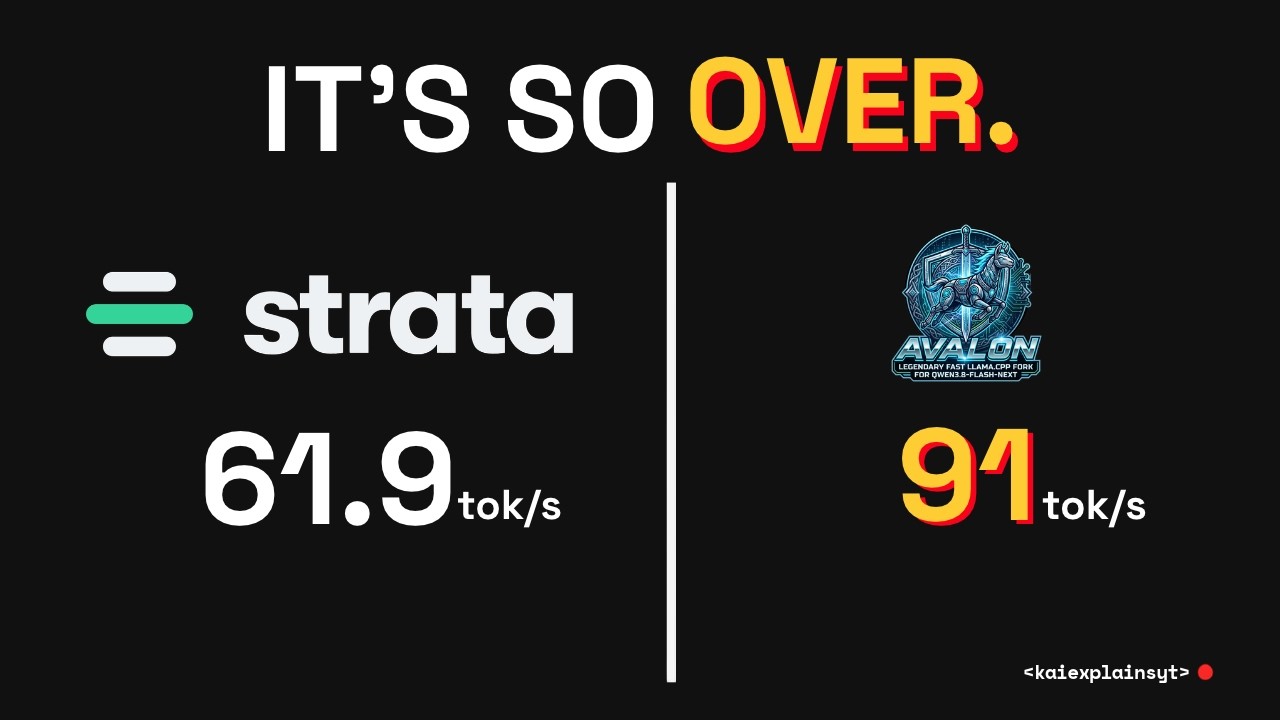
Avalon Just Beat Strata by 47% on AMD (9x Faster)
Avalon vient de battre Strata de 47% sur AMD (9x plus rapide)
★
★
★
★
★
5/5
@kaiexplainsyt
Avalon vient de battre Strata de 47% sur AMD (9x plus rapide)
Chaque façon d'obtenir 256 Go de VRAM pour l'IA locale en contexte complet
Votre plan ChatGPT à 200 $ vaut désormais moins !

Votre GPU est bridé pour l'IA locale (La limite cachée de NVIDIA)

Votre PS5 peut désormais exécuter des modèles ouverts (et c'est étonnamment rapide)

Flint est-il le tueur de Qwen 3.8 27B ? (Premier modèle RSI)

DeepSeek est gratuit maintenant, mais quel est le piège ?

Le Harness² de Google est-ce la fin de l'ingénierie des harnais ?
llama.cpp vient de rendre les modèles MoE de 125B 4× plus rapides

Votre IA locale n'est pas aussi privée que vous le pensez

J'ai Testé Chaque Meilleure IA Locale Pour GPU (8GB À 24GB VRAM)

OpenCode a été sérieusement piraté (Mes clés API ont été épuisées)

Comment j'ai obtenu des performances de pointe sur 16 Go de VRAM (Qwen 3.8 27B)

Chaque façon d'obtenir 512 Go de VRAM pour l'IA locale (avec contexte complet)
Qwen 3.8 27B vient d'atteindre 200 token/s sur Mac M5 (Lithos Metal)
Le matériel IA local est devenu bien plus cher que vous ne le pensez

Pourquoi votre Mac est lent en IA locale (et ce n'est pas la puce)
Une GPU de 9 ans peut-elle battre les GPU les plus récents d'aujourd'hui ?
N'achetez pas de GPU, construisez plutôt ce serveur IA gratuit de 32 Go
N'achetez pas un ordinateur portable RTX Spark pour l'IA locale avant d'avoir vu ceci
Toutes les façons d'obtenir 128 Go de VRAM pour l'IA locale en contexte complet

Les logiciels coûtent des millions à créer, mais Claude l’a résolu en quelques secondes. (Pt - 1)

Claude a-t-il été discrètement nerfé après le lancement..(Nous avons des preuves)

16 Go suffisent-ils pour un LLM local sérieux ?

La fin des hallucinations de l'IA ? Le nouveau correctif de Meta (CLM)
OpenRouter donne silencieusement un modèle d'IA nerfé (ARRÊTEZ d'utiliser le mauvais endpoint)

Deepseek et Huawei ont fait fonctionner l’IA locale sans CUDA de NVIDIA (et pourquoi c’est difficile)
Toutes les façons d'obtenir 32 Go de VRAM pour l'IA locale en contexte complet

La nouvelle façon d'exécuter des modèles 125B 6 fois plus vite que llama.cpp (Strata)
Xiaomi et DeepSeek viennent de résoudre le plus grand goulot d'étranglement de votre IA locale

À quelle vitesse est l'IA locale sur votre Mac ? (Chaque puce, du M1 au M6)

Le bail de 288 milliards de dollars d’Oracle : la dette dont ils ne peuvent s’échapper
Un Mac Mini peut-il remplacer votre abonnement IA à 200 $ ?
Ce que coûte réellement l’exécution de Xiaomi MiMo V2.6 Pro et Flash en local

J'ai testé tous les modèles d'IA locaux pour que vous n'ayez pas à le faire

Le milliard de dollars de DeepSeek est une hausse de prix, pas une croissance

Est-il possible d'exécuter n'importe quel LLM en mode Jev en utilisant llama.cpp ?
N'achetez pas un Mac Mini pour l'IA locale (Faites ceci)